
为什么?
先看这两个分数是怎么来的。RAG 会先把文档切成一段一段的分块存进知识库,用户提问时,先从知识库里检索出相关的分块,再交给大模型生成答案。检索这一步有两种常见的做法。
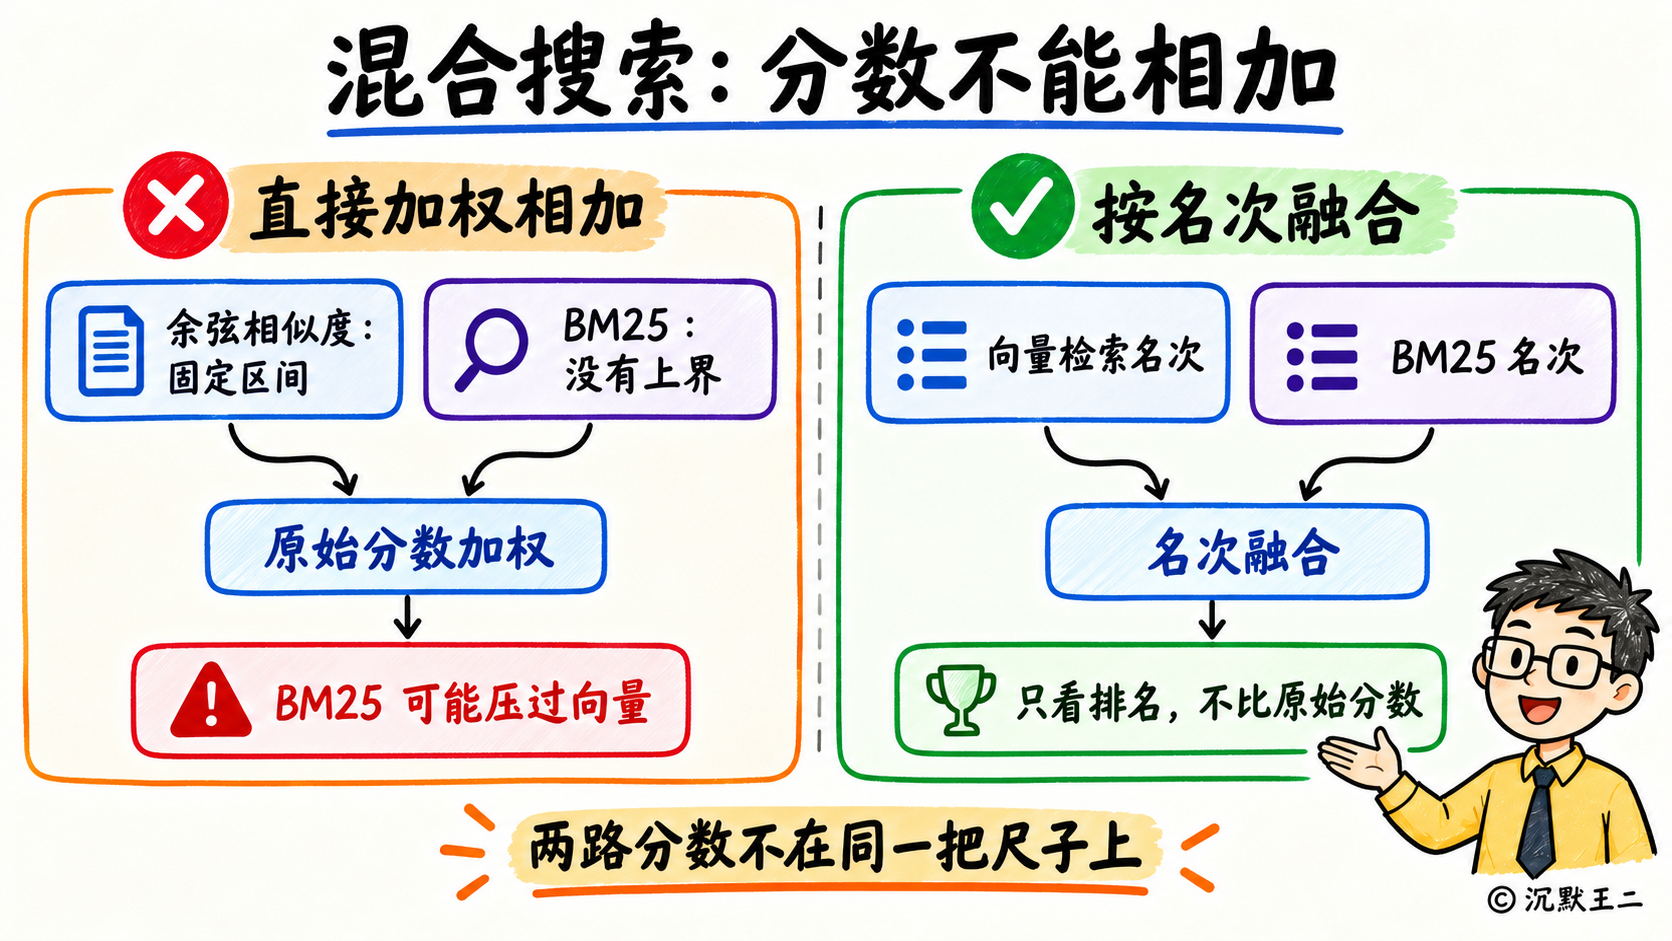
向量检索比较的是问题和分块的意思有多接近,这个分数叫向量相似度,最高只有 1。关键词检索比较的是字面上有没有命中,命中的频率是多少,最常用的打分算法叫 BM25。BM25 的分数没有固定的最大值,问题里的关键词在分块里命中得越多,分数就越高,可能远远超过 1。
所以这两个分数没法直接放在一起加权重,0.7 还是 0.3 都不合适。一个问题命中的关键词少,BM25 分数不高。换一个命中关键词多的问题,BM25 的分数一下子涨上去了,乘以 0.3 会比向量那边的权重大得多,排序几乎全由 BM25 决定,向量检索就白做了。
我翻了派聪明的源码、RRF 的论文和 Elasticsearch 的官方文档,可以自信地、大方地、光明磊落地帮你搞清楚这三件事。
- RAG 为什么要做向量和关键词的混合检索?
- 向量和关键词的两路结果到底怎么合并?
- 合并完能直接交给大模型了吗?
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲透 RAG 里的混合检索。
RAG 的结果符不符合预期,检索是第一步。正确的分块没有被检索出来,大模型再强,也只能给一个没有参考价值的答案。
向量检索是先把文本转成 Embedding,也就是一串表示语义的数字,再去找意思最接近的分块。Anthropic 在《Contextual Retrieval》举过一个例子,用户在技术支持文档里查“Error code TS-999”,Embedding 能找到一堆讲错误码的内容,却可能偏偏漏掉 TS-999 这一条。
BM25 按问题里的词在分块里出现的次数和这个词的稀有程度打分。用户问“怎么退款”,文档里写的是“退货流程”,BM25 就匹配不上。
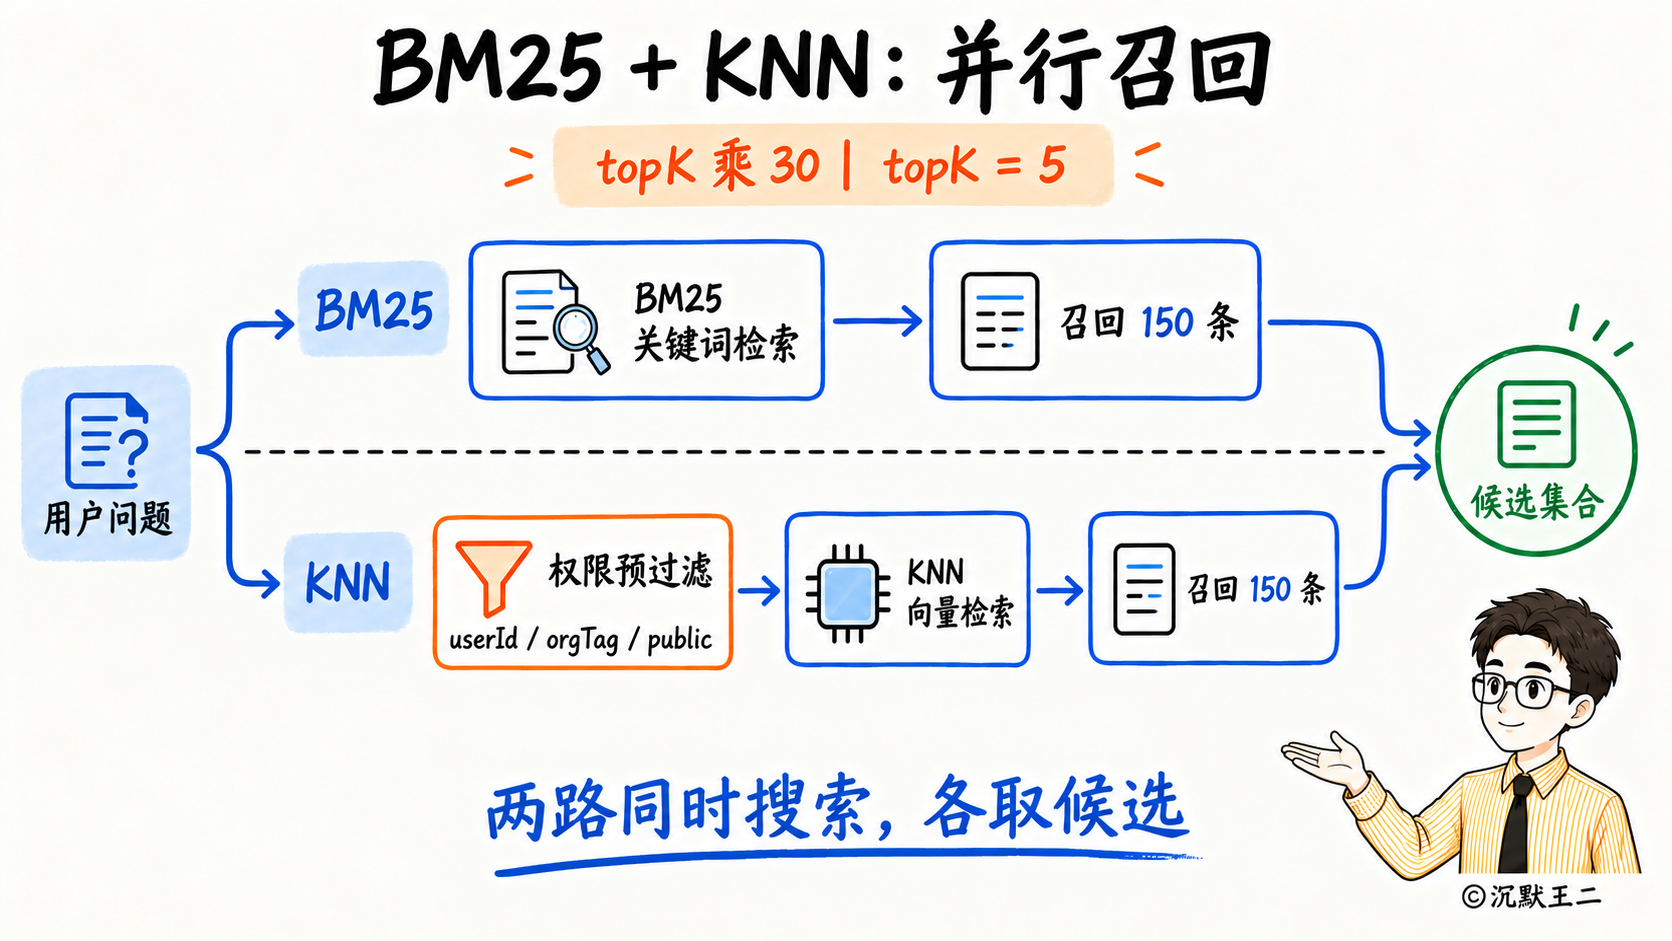
所以派聪明的做法是两路一起上。BM25 关键词检索和 KNN 向量检索在两个线程里并行召回。KNN 的意思是找出和问题向量最接近的 K 个分块。每一路取 topK 乘 30 条,上限 300 条,topK 是最终交给大模型的分块数,等于 5 的时候,每一路就召回 150 条。
KNN 这一路还把 userId、orgTag、public 三个权限条件放进了预过滤。预过滤的意思是 Elasticsearch 在做向量搜索的过程中,就把当前用户没有权限的分块排除掉。如果先搜索再过滤,150 条候选里可能一大半是别人的文档,过滤完剩下的就不够用了。
那聪明的你肯定想到了:两路的分数没法相加,结果到底怎么合并?
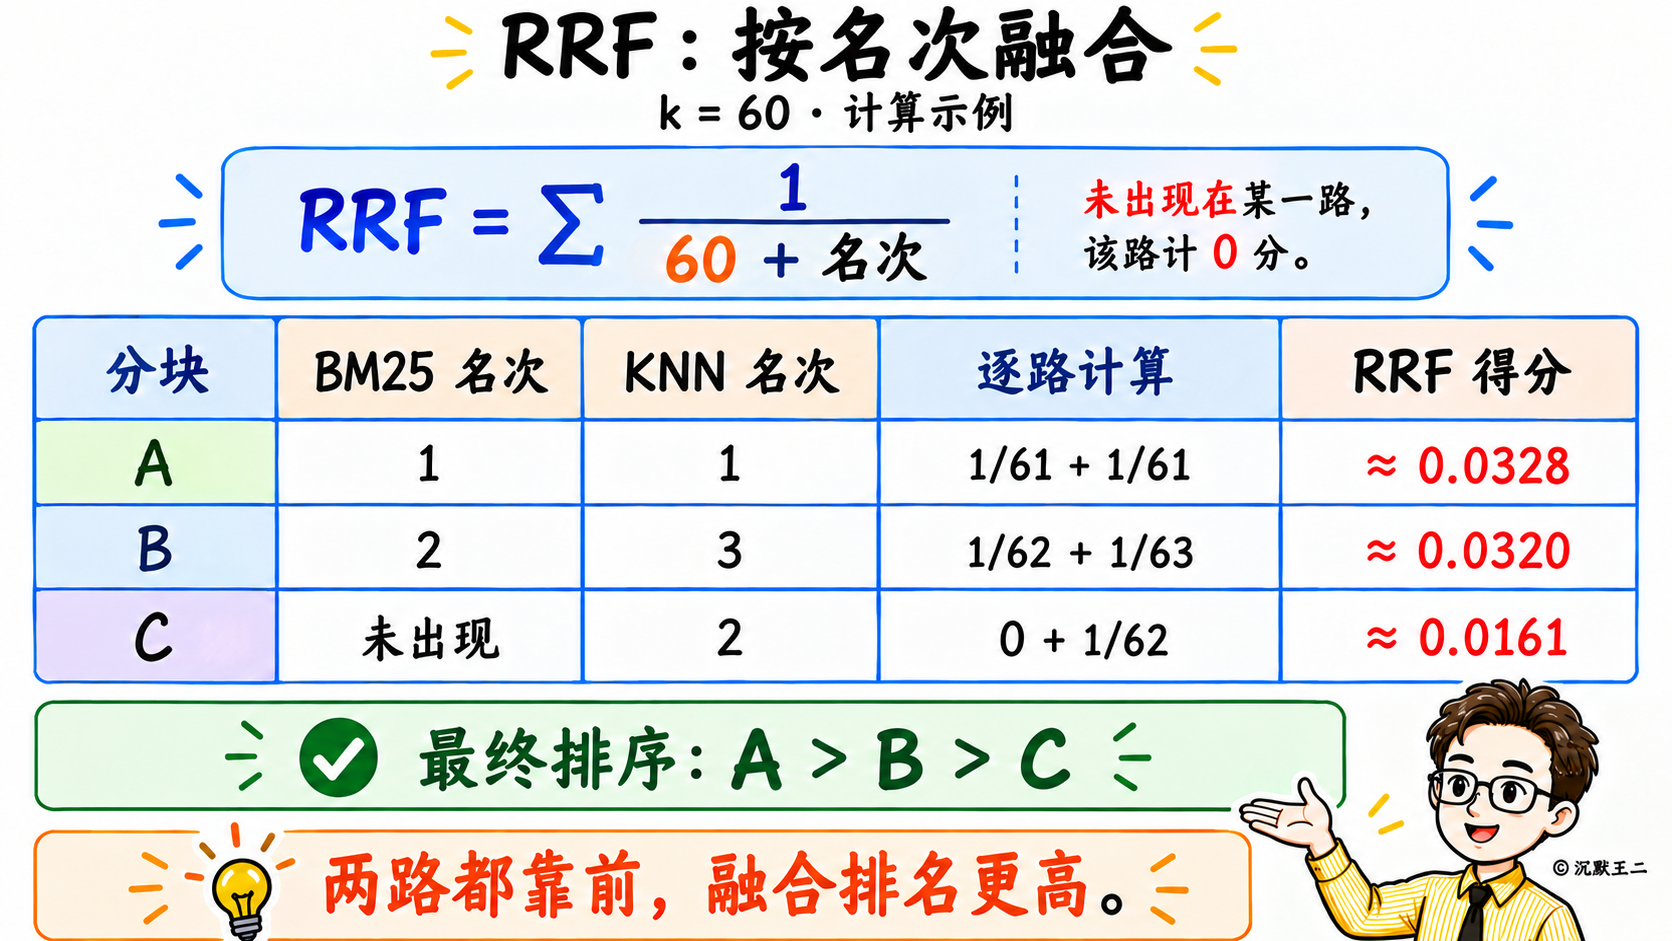
答案是 RRF,全称 Reciprocal Rank Fusion,倒数排名融合。它不看分数,只看名次。一个分块在某一路排第几名,就得到 1 除以 60 加名次的分数,两路的分数再加起来。
60 不是随便定的。它出自 2009 年 SIGIR 会议上 Cormack 等人的论文,作者在试点实验里把这个常数从 0 调到 500,效果差别很小,60 接近最优,就固定了下来。
一个分块在两路里都排第一,得分是 2 除以 61,大约 0.0328。只在一路里排第一、另一路里没有出现,得分只有一半,大约 0.0164。两路都认可的分块,排名自然就会靠前。
那派聪明为什么要手写 RRF,不直接用 Elasticsearch 自带的 RRF 呢?
因为派聪明部署的 Elasticsearch 是 8.10.4 版本,用的是免费的 basic license。Elasticsearch 的 retriever 接口从 8.14 版本才开始提供,原生 RRF 还需要商业授权。RRF 的核心公式在代码里只有一行,自己实现的成本很低。
那聪明的你肯定又要问了:合并完就能直接交给大模型生成答案了吗?
还不行,这也是面试官最想听到的部分。
RRF 只是按名次粗排,它并不知道分块的内容和问题到底有多相关。所以派聪明会把 RRF 排名前 50 的分块交给 gte-rerank-v2 这个 Rerank 模型,也就是重排序模型。Rerank 模型把问题和每个分块放在一起逐条打分,只保留 0.1 分以上的结果,再取前 5 条交给大模型。
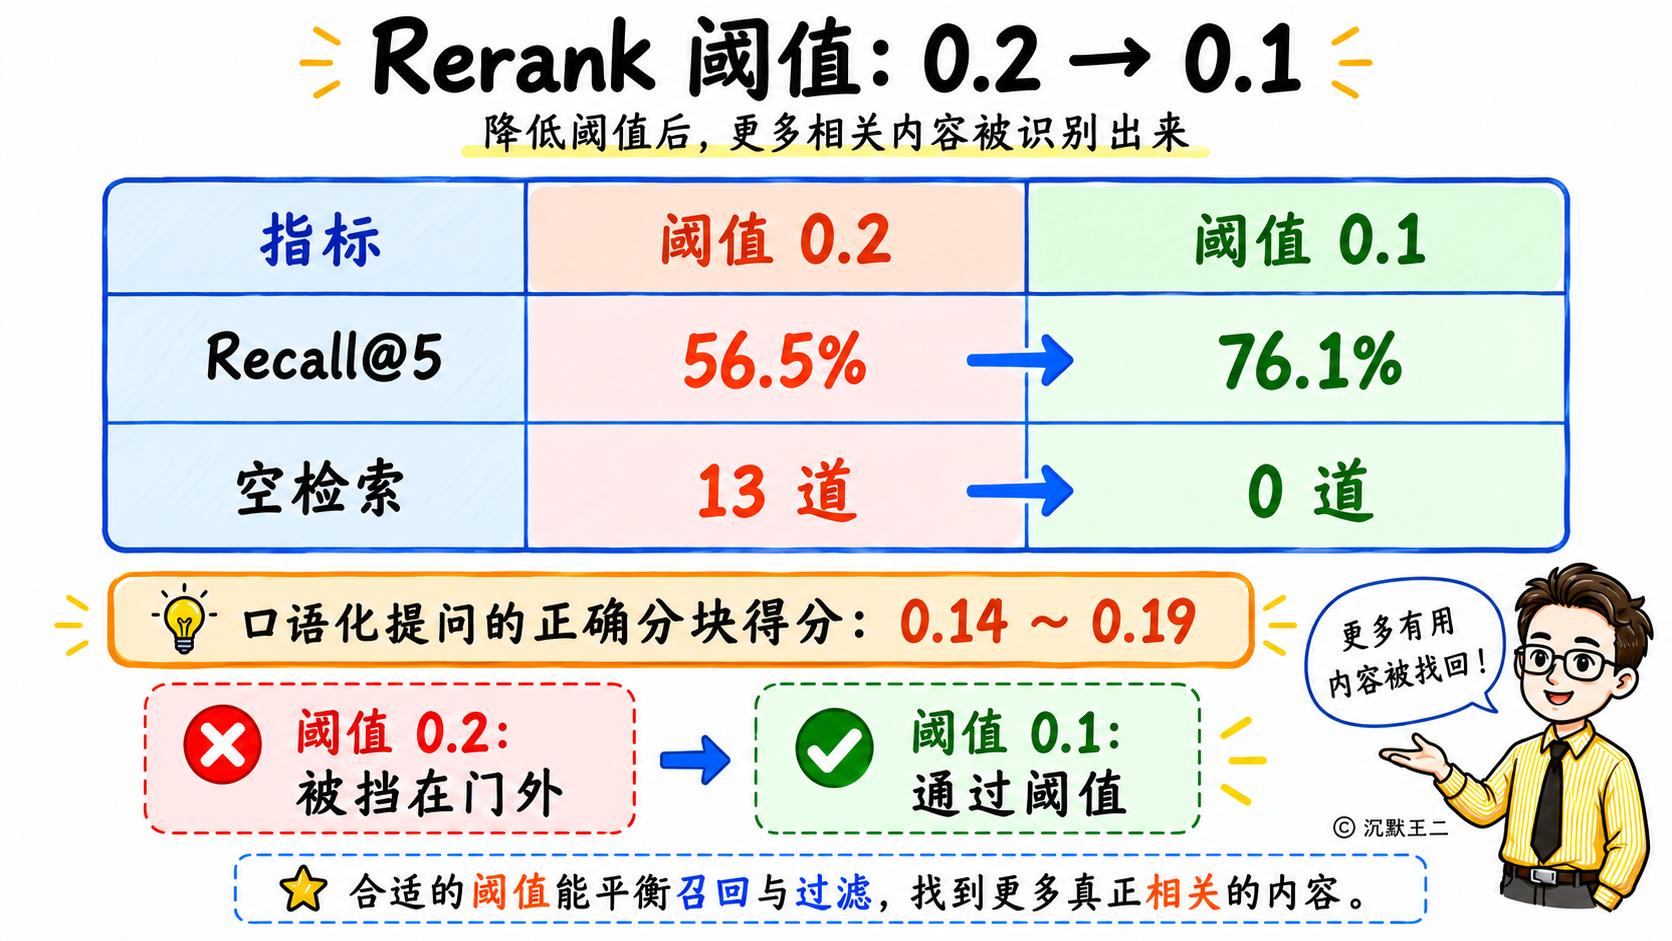
这个 0.1 是测评出来的。10 月 11 日,派聪明用 50 道带标准答案的题做评测。阈值原来是 0.2,分块级的 Recall@5 只有 56.5%,Recall@5 就是正确分块出现在前 5 条结果里的比例,还有 13 道题一条结果都没有检索到。原因是用户口语化提问的时候,正确分块的 Rerank 分数只有 0.14 到 0.19,全被 0.2 挡在了门外。阈值降到 0.1 以后,Recall@5 升到 76.1%,空检索降到 0 道。
10 月 13 日,派聪明又做了一轮分阶段评测,召回阶段的 Recall@50 已经达到 100%,所有正确分块都在候选里,短板在重排序。
还有一个容易踩的坑是降级。旧版代码里,任何一路召回超时,两路的结果会一起丢掉,退回纯 BM25 检索。现在改成了一路失败,就用另一路的结果继续做 RRF 和 Rerank。Rerank 超时或者出错,就按 RRF 的顺序返回,再用一个分数阈值过滤掉排名太靠后的分块。
最后简单总结下。
RAG 里的混合检索不是把两个分数加权相加,而是两路各自召回、按名次融合、再交给 Rerank 精排,最后把前几条分块交给大模型生成答案。
另外给大家一条实用建议,调整任何阈值之前,先建一份带标准答案的评测集。每改一个参数,就用 Recall@5 和 MRR 测评一次,MRR 看的是第一个正确结果平均排得有多靠前。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!