
手搓 Java 版 Claude Code 第 2 期,先出计划再动手,按 DAG 分批并行执行
大家好,我是二哥呀。
第 1 期的 ReAct 已经能干活了,读文件、改代码、跑命令,一步接一步。
可任务一长,比如“读 pom.xml、看看源码结构、再写一份升级方案”,问题就来了。我们在 Agent 动手之前不知道它打算怎么做,互不相干的几步也没法同时跑。中途哪一步错了,只能等它自己发现。
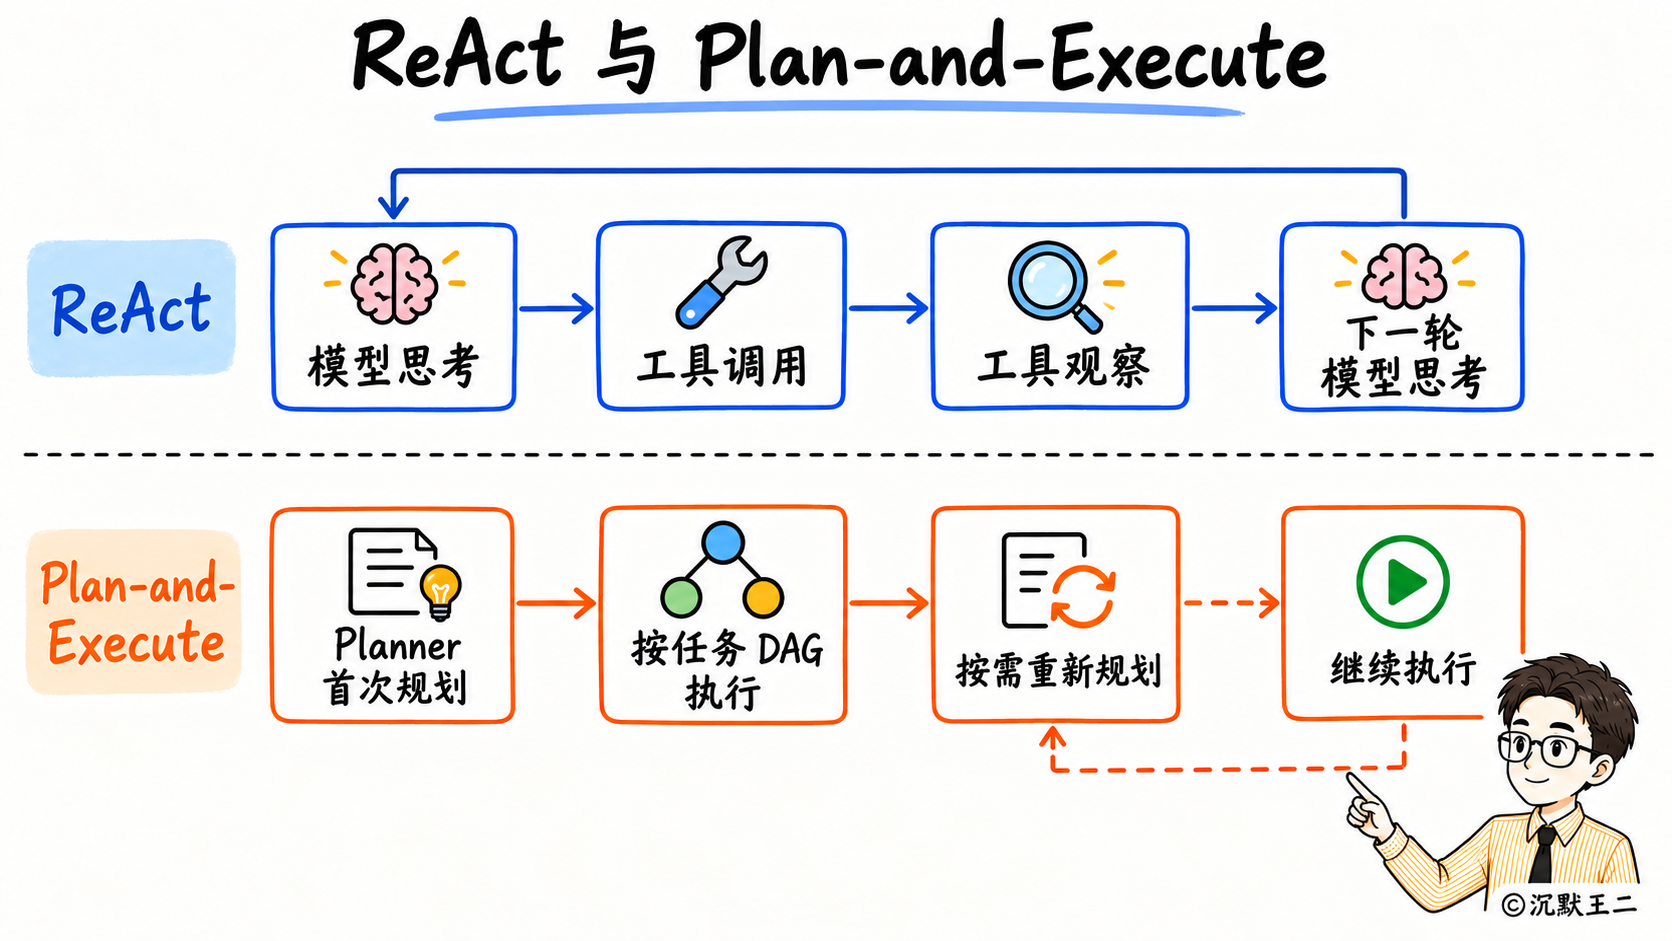
这一期我们给 PaiCLI 加上 Plan-and-Execute。模型先出一份带依赖关系的任务清单,我们确认之后,PaiCLI 按依赖分批执行这些任务,互不依赖的任务还可以并行。
01、先规划再执行
Plan-and-Execute 把一次任务交给两个角色。规划器(Planner)负责出计划,它调用模型时不给任何工具,只要求模型输出一份 JSON 格式的计划。执行器(PlanExecuteAgent)拿着这份计划,按依赖关系一批一批地跑任务。正常情况下规划器只调用一次模型;用户审阅时补充要求,或者任务失败后需要重新规划,规划器会再调用模型。
“Plan 模式”在不同产品里做法不一样。Pi 是一款开源的终端编程 Agent,它的 Plan 模式只做只读调研,通过
setActiveTools把 edit 和 write 两个写文件工具拿掉,bash 也只放行只读命令。PaiCLI 的做法不同,只有规划器调用模型时不带工具,执行器执行每个任务时,读写文件、执行命令这些工具都照常可用。两种做法的对比可以阅读《Plan模式死了吗?》
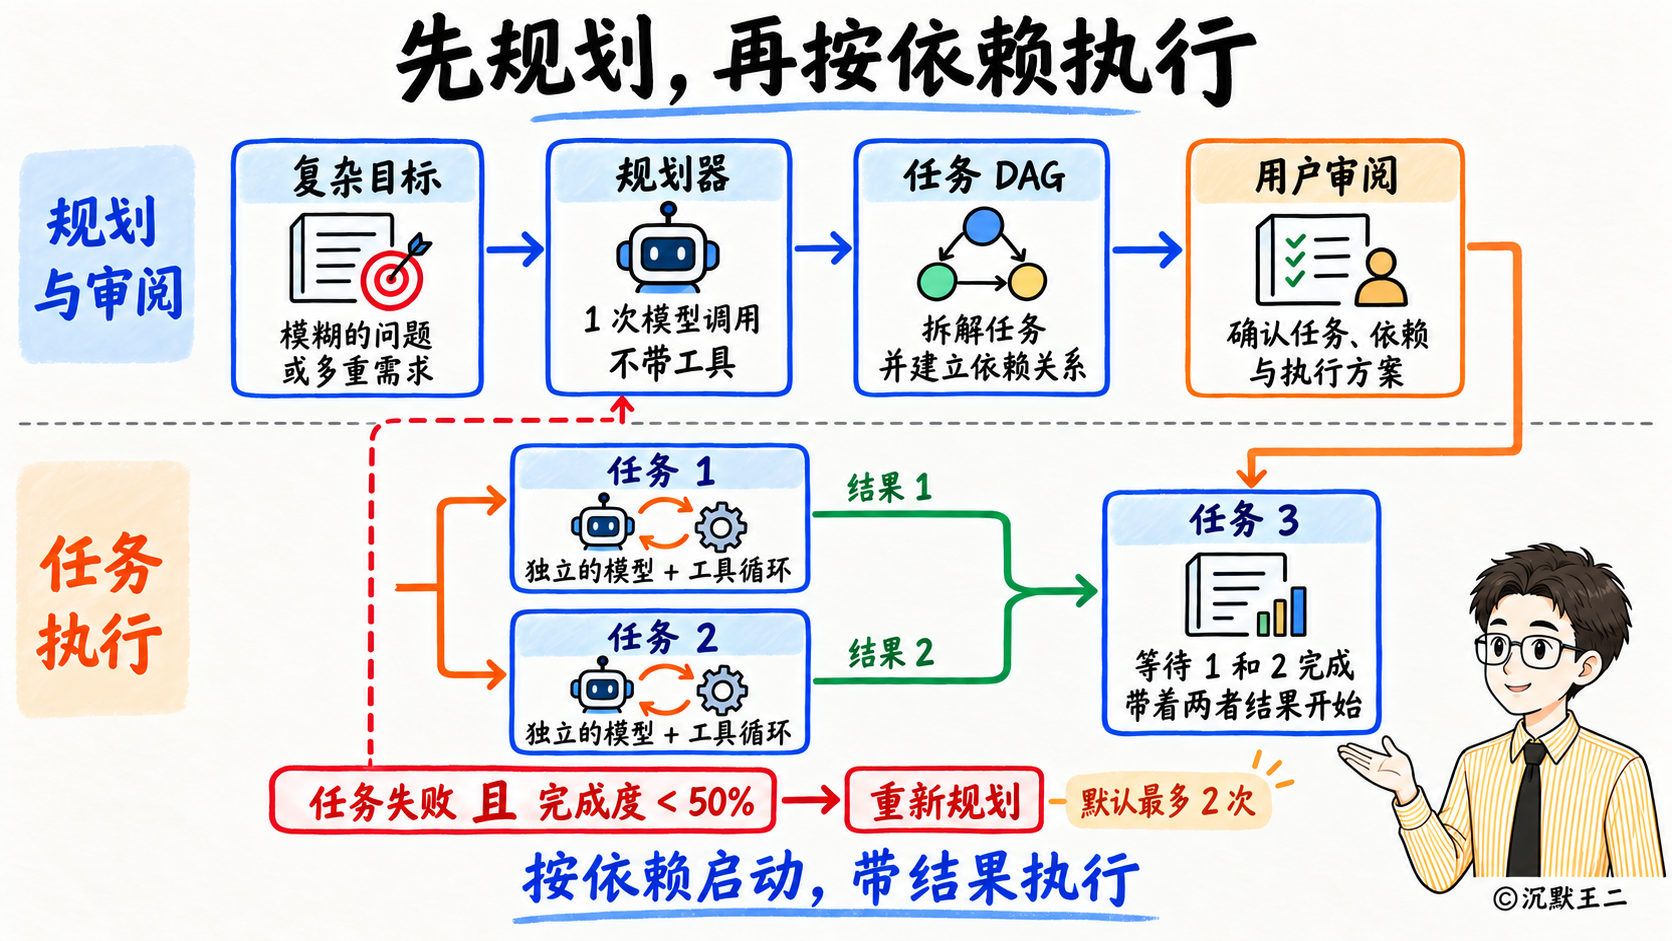
每个任务内部,跑的还是第 1 期 ReAct。模型决定调用什么工具,工具结果交回模型,直到模型不再调用工具,这个任务就算完成。
在 Agent 开始动手之前,我们能看到完整的计划,可以确认、补充要求或者直接取消。读 pom.xml 和列出 src 目录这种没有先后关系的任务,可以同时跑。每个任务拿到的上下文也更干净,只有总目标、任务描述和直接依赖的结果。
两种模式放在一起比一下。
| 对比项 | ReAct | Plan-and-Execute |
|---|---|---|
| 模型调用次数 | 由 Action 轮数决定 | 多一次规划,每个任务至少一次 |
| 耗时 | 取决于 Action 轮数 | 多一次规划等待,独立任务并行时可能更快 |
| 执行前能否看到步骤 | 不能 | 能,还能补充要求后修改计划 |
| 适合的任务 | 简单任务、边看边决定的探索 | 步骤多、依赖明确、想先看清流程的任务 |
02、计划长什么样
一个任务就是一个节点。
// src/main/java/com/paicli/plan/Task.java
public class Task {
    private final String id;
    private final String description;
    private final TaskType type;
    private volatile TaskStatus status;
    private volatile String result;
    private volatile String error;
    private final List<String> dependencies;  // 依赖的其他任务ID
    private final List<String> dependents;    // 依赖此任务的其他任务ID
}
任务类型有 5 种,FILE_READ、FILE_WRITE、COMMAND、ANALYSIS、VERIFICATION。执行任务时,任务类型会填进发给模型的提示词里,提醒模型这一步是读任务、写任务还是分析任务。类型不限制模型能用哪些工具。
dependencies 记录这个任务依赖哪些任务,用来判断它能不能开始执行;dependents 记录哪些任务依赖它,这个任务失败时,顺着 dependents 就能找出所有受影响的任务。下文把依赖某个任务的任务叫作它的“下游”。
任务状态有 5 种。
PENDING → RUNNING → COMPLETED / FAILED
PENDING → SKIPPED(依赖的任务失败,或者重新规划次数达到上限,见第 07 节)
能不能开始执行,只看一个条件,所有依赖是否都已经完成。
public boolean isExecutable(Map<String, Task> allTasks) {
    if (status != TaskStatus.PENDING) return false;
    for (String depId : dependencies) {
        Task dep = allTasks.get(depId);
        if (dep == null || dep.getStatus() != TaskStatus.COMPLETED) {
            return false;
        }
    }
    return true;
}
依赖失败或者被跳过,下游会等不到 COMPLETED,所以失败处理必须主动把下游标成 SKIPPED,不然会一直停在 PENDING。
并行执行时有两类线程。调度线程是运行执行器主循环的那个线程,任务的状态和结果都由它写,任务开始前标记为 RUNNING,收回结果后标记为完成或失败。工作线程是线程池里真正执行任务的线程,它们只读取依赖任务的结果。调度线程写完再把任务提交给线程池,工作线程执行完,调度线程通过 Future.get() 取回结果。Java 保证提交之前的写入对工作线程可见,工作线程的写入在 Future.get() 返回后对调度线程可见,所以不会读到旧值,字段上的 volatile 算多一层保险。
拓扑排序和环检测
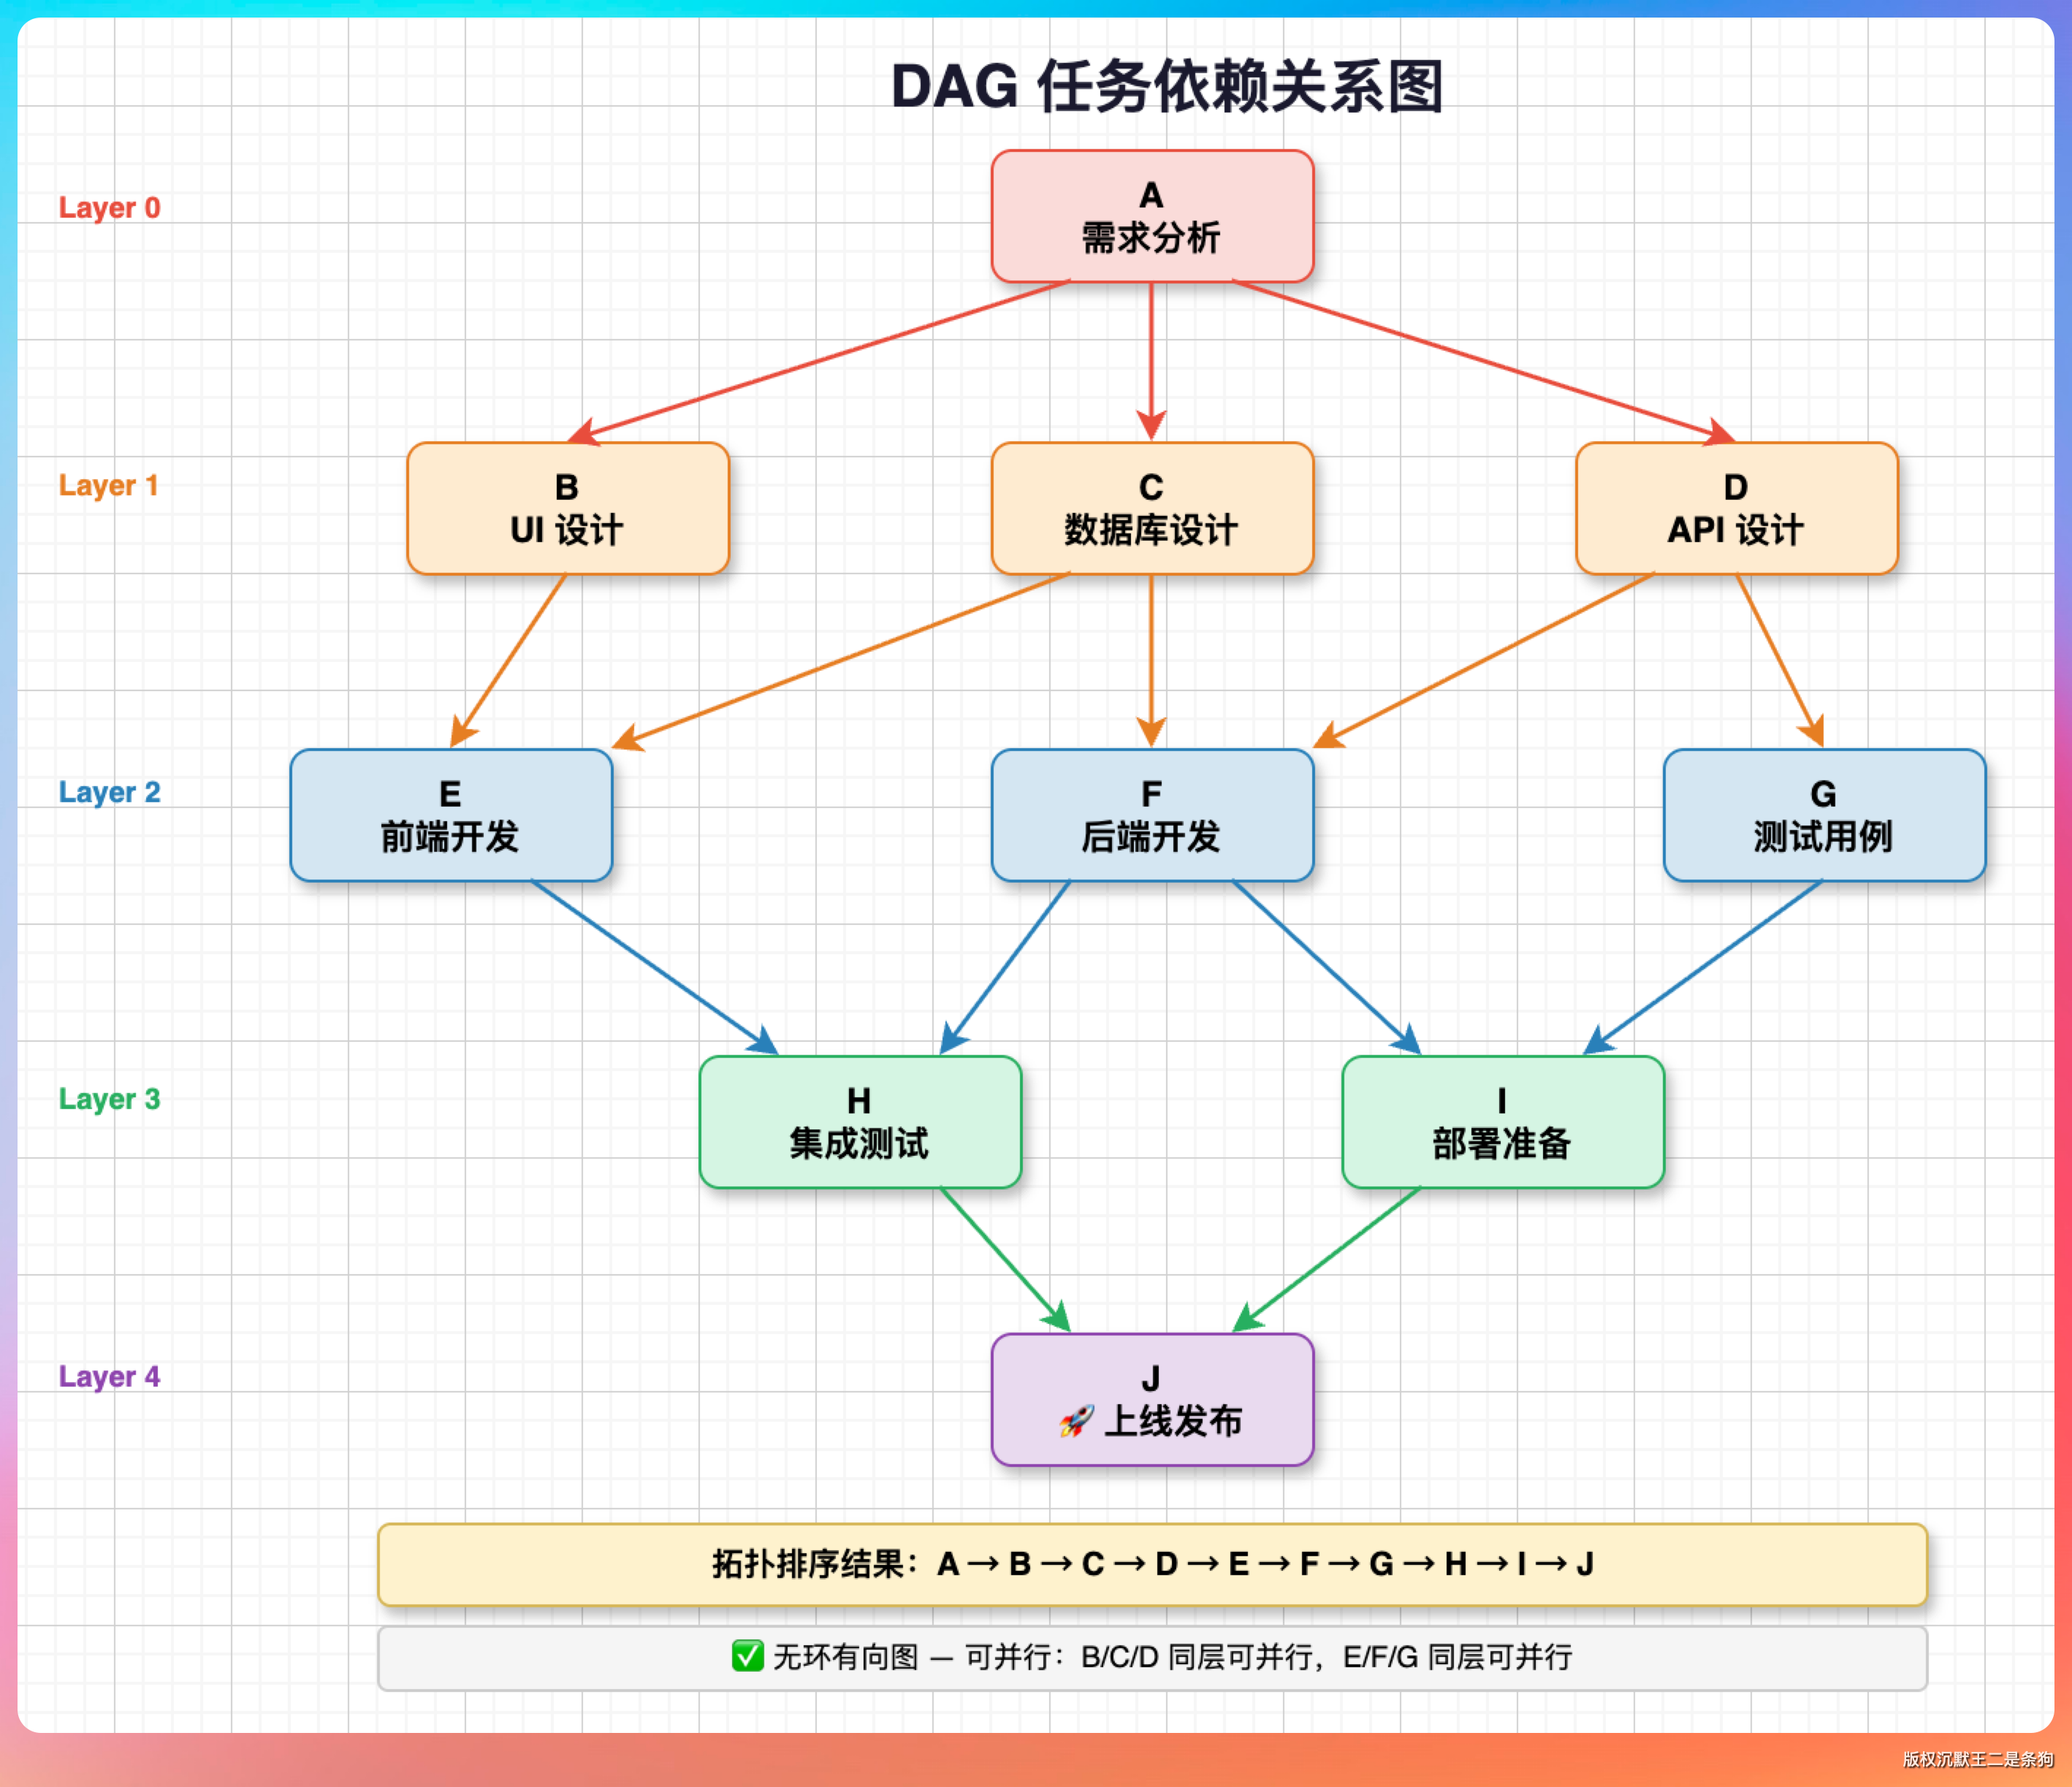
多个任务组成一个执行计划(ExecutionPlan),任务按插入顺序存在 LinkedHashMap 里,另外维护一份拓扑排序后的顺序。拓扑排序是把有依赖关系的任务排成一个序列,保证每个任务都排在它依赖的所有任务后面。
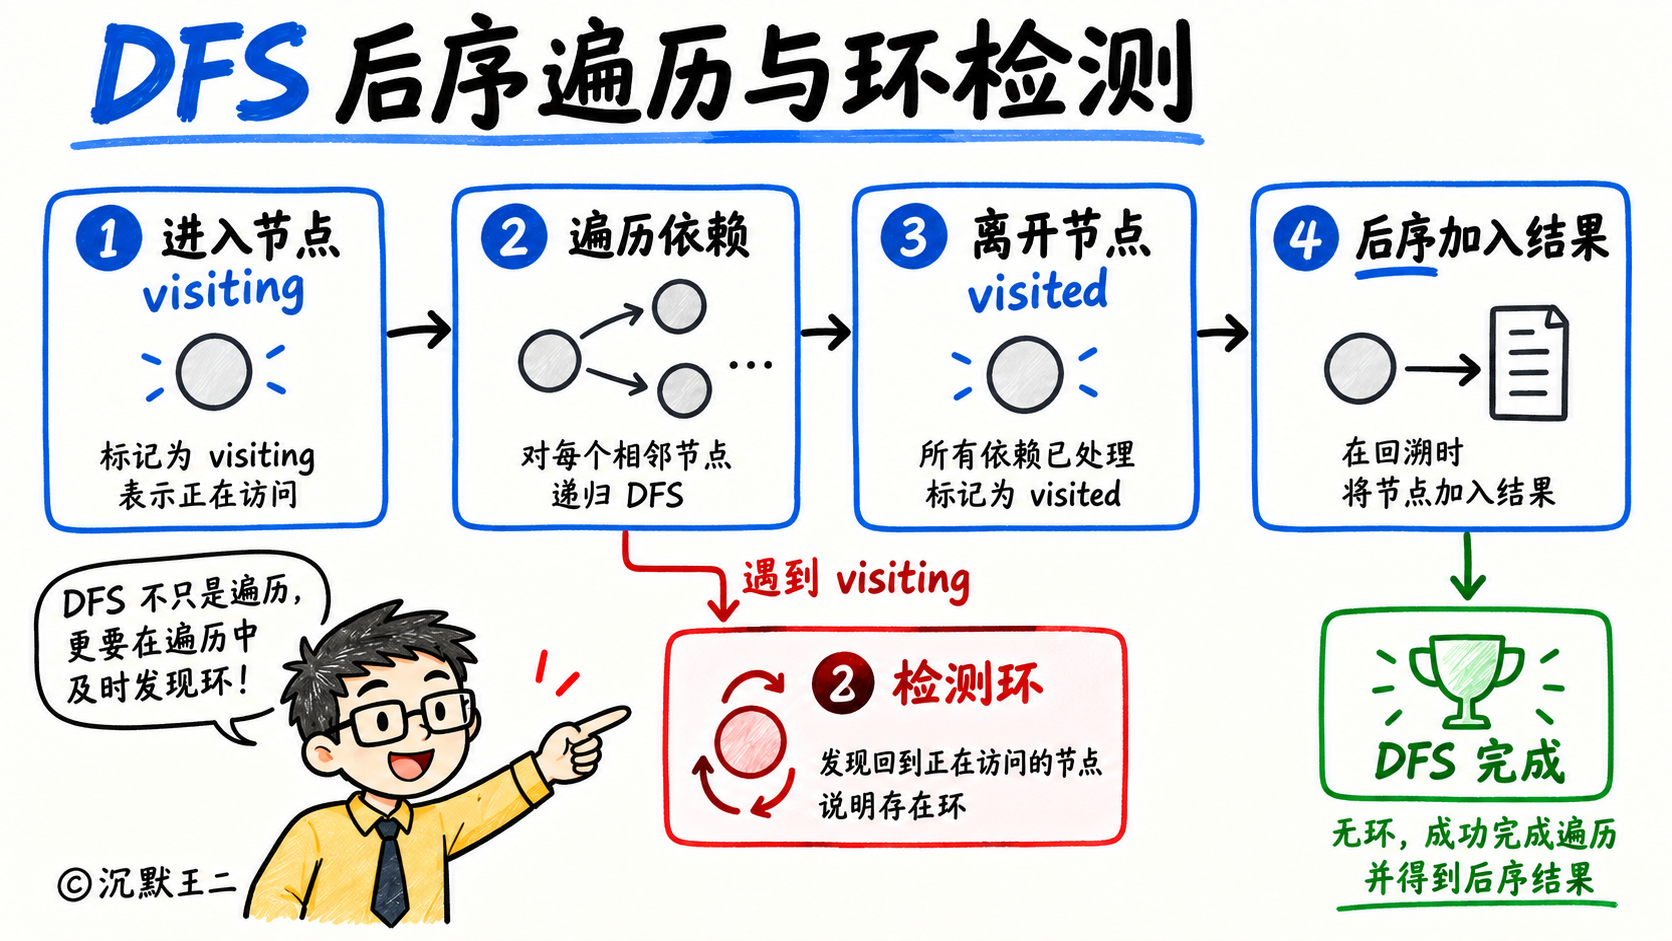
PaiCLI 的拓扑排序用 DFS(深度优先搜索)后序遍历实现。“后序”的意思是,先递归处理完一个任务的所有依赖,再把这个任务本身加进结果,所以得到的顺序天然就是依赖在前。
// src/main/java/com/paicli/plan/ExecutionPlan.java
private boolean topologicalSort(Task task, Set<String> visited, Set<String> visiting) {
    String id = task.getId();
    if (visiting.contains(id)) {
        return false;  // 有环
    }
    if (visited.contains(id)) {
        return true;
    }
    visiting.add(id);
    for (String depId : task.getDependencies()) {
        Task dep = tasks.get(depId);
        if (dep != null && !topologicalSort(dep, visited, visiting)) {
            return false;
        }
    }
    visiting.remove(id);
    visited.add(id);
    executionOrder.add(id);
    return true;
}
visiting 是当前递归栈上的节点,递归中又碰到它,说明依赖绕回来了,比如 A 依赖 B,B 依赖 C,C 又依赖 A。visited 是已经处理完的节点,避免重复遍历。
排出来的顺序不直接决定谁先跑。调度靠每一轮重新筛可执行的任务,拓扑顺序只负责给同一轮的任务排先后,另外决定计划展示、跳过标记和失败汇总里的列出顺序。
计划本身也有状态,CREATED、RUNNING、COMPLETED、FAILED、CANCELLED,用户按 ESC 中断执行时标成 CANCELLED。
03、凭什么信任模型给的计划
计划是模型写的。规划器先把要求讲清楚,再对模型交回来的东西严格验收。
先看规划请求。
// src/main/java/com/paicli/plan/Planner.java
public ExecutionPlan createPlan(String goal) throws IOException {
    out.println("📋 正在规划任务: " + goal + "\n");
    return requestPlan(goal, "请为以下任务制定执行计划:\n" + goal);
}

private ExecutionPlan requestPlan(String goal, String planningRequest) throws IOException {
    List<LlmClient.Message> messages = Arrays.asList(
            LlmClient.Message.system(promptAssembler.assemble(PromptMode.PLANNER, PromptContext.builder()
                    .projectMemoryContext(buildProjectMemoryContext())
                    .build())),
            LlmClient.Message.user(planningRequest));
    LlmClient.ChatResponse response = llmClient.chat(messages, null, streamRenderer);
    return parsePlan(goal, response.content());
}
规划请求只有两条消息。system 消息是拼装好的规划提示词,user 消息是“请为以下任务制定执行计划”加上用户的目标。chat 的第二个参数传 null,表示规划请求不带任何工具。终端上流式显示模型的思考过程,JSON 正文不直接输出。
规划提示词
提示词放在 prompts/modes/planner.md,拼装时带上 PAI.md。PAI.md 是放在项目根目录下的项目规则文件,写着团队希望 Agent 遵守的约定,第 3 期细讲。提示词里给了 JSON 格式的示例、5 种任务类型,结尾强调“只输出 JSON,不要有其他内容”。其中和拆分粒度有关的规则如下(节选,编号和原文件一致)。
5. 简单任务允许只生成 1-3 个任务,不要为了凑步数引入无关步骤。
6. 复杂任务拆分为 5-10 个子任务。
7. 不要为了“保存中间结果”额外创建 FILE_WRITE / FILE_READ,除非用户明确要求落盘。
8. 如果一个任务一步就能完成,就保持最短计划。
9. 没有依赖关系的任务会并行执行。会写同一个文件的任务不能同时执行,必须让后一个依赖前一个。
一步就能完成的目标也交给模型规划
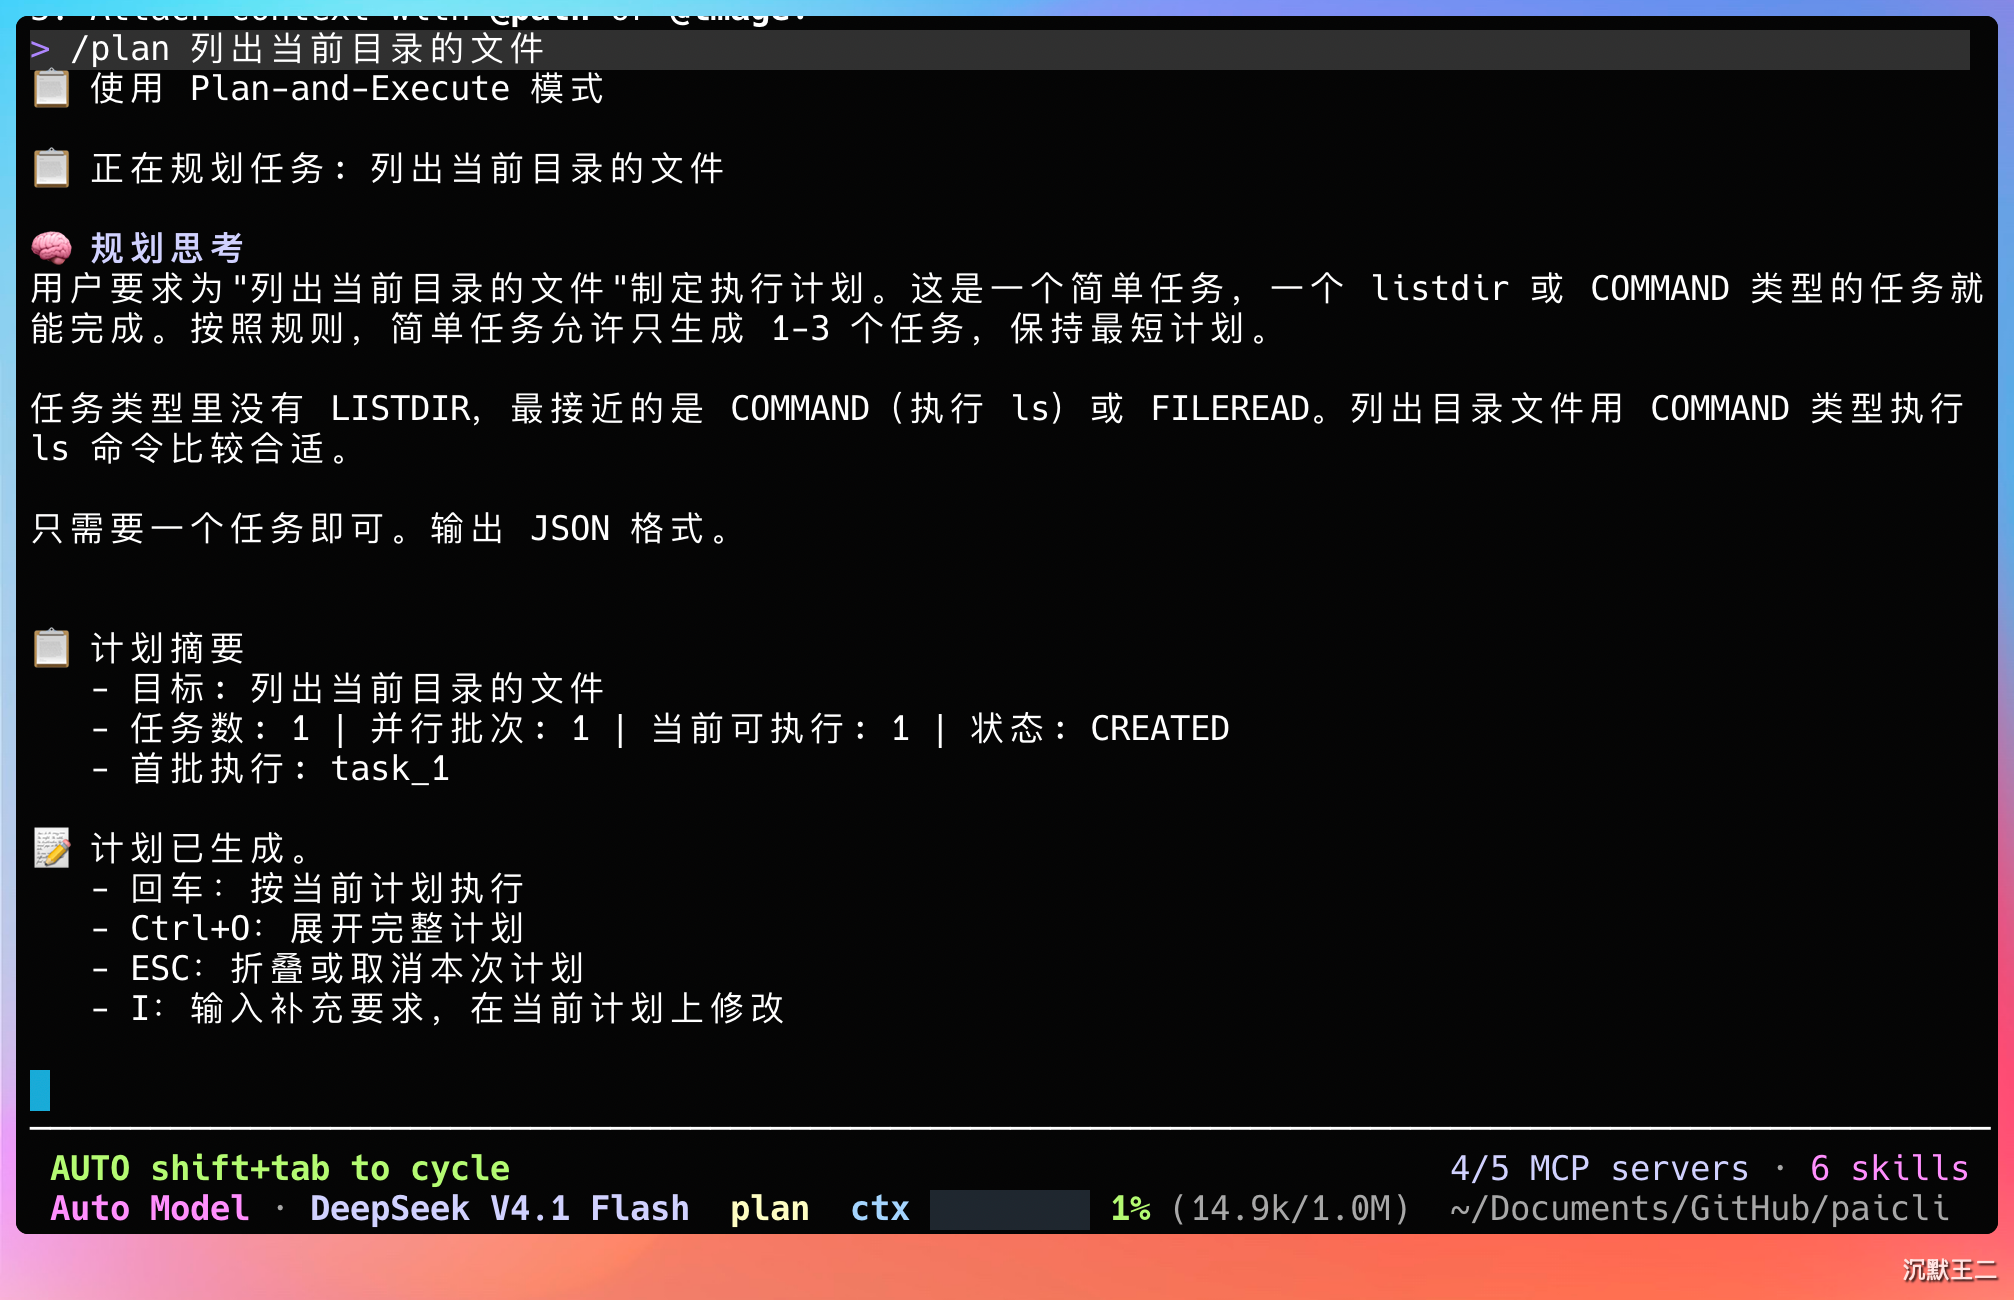
/plan 列出当前目录的文件 这条输入,一步就能完成,规划器向模型发一次规划请求。上面第 5 条和第 8 条规则规定了这种情况怎么处理,一步能完成就保持最短计划,所以模型交回来的计划只有一个任务。
在调用模型之前用规则判断“这个任务很简单,不用规划”,能省掉这一次规划请求。但规则只能检查输入里有没有某些词、字数有多少,判断不了一条输入实际要做哪几件事。下面两条输入都很短,也都不含“然后”、“最后”这类表示多个步骤的词,按规则都会被当成一步完成的任务。
“删除 src 下所有文件”会删掉一整个目录下的文件。按规则直接生成单任务计划,审阅时用户看到的只有这一行原文,计划里没有原文之外的任何信息,也就起不到审阅的作用。
“执行 mvn test,修复失败的测试”要先运行测试、再改代码,是两个有先后关系的步骤。按规则它只会变成一个任务,计划里看不出这层依赖。
所以 PaiCLI 定了一条原则,根据用户原话做的判断,只用来收紧 Agent 的能力,比如用户说了“不要联网”就收起联网工具;不用来替用户跳过步骤。规划要不要拆、拆成几个任务,一律交给模型判断,再由紧接着的“严格校验”这一小节讲的规则把关。
代价是每条输入多一次规划请求。规划请求不带工具,模型只输出一段计划 JSON,比执行任务时的请求轻得多。如果觉得一条简单输入也要规划太麻烦,按 Shift+Tab 切回 auto 模式即可。auto 模式是 PaiCLI 启动时的默认模式,这个模式下的普通输入直接交给 ReAct 执行,不经过规划器。
严格校验
模型交回来的计划,任何一项不合格都直接失败。下面的代码从 Planner.parsePlan 里摘出几段关键判断,省略了变量声明。
String cleaned = planJson.replaceAll("```json\\s*", "")
        .replaceAll("```\\s*", "")
        .trim();
JsonNode root;
try {
    root = mapper.readTree(cleaned);   // JSON 后面跟说明文字、键重复都算不合法
} catch (JsonProcessingException e) {
    throw new IOException("计划不是合法的 JSON:" + e.getOriginalMessage(), e);
}
// 第一遍:登记所有 id,重复即失败
if (idMapping.putIfAbsent(originalId, "task_" + taskIndex++) != null) {
    throw new IOException("计划中存在重复任务 id");
}
// 第二遍:建立依赖,引用未声明的 id 即失败
if (!depNode.isTextual() || !idMapping.containsKey(depNode.asText())) {
    throw new IOException("计划依赖必须引用已声明的任务 id");
}
// 最后:拓扑排序失败说明有环
if (!plan.computeExecutionOrder()) {
    throw new IOException("计划中存在循环依赖");
}
解析需要两次遍历。因为模型可能先写 task_2,再写 task_1,而 task_2 依赖 task_1。第一遍只登记 id,第二遍再连依赖,这样一个任务引用了排在它后面才声明的 id,也不会被误判成“引用了不存在的任务”。不管模型给的 id 叫什么,最后都按数组顺序重新编号成 task_1 到 task_N。
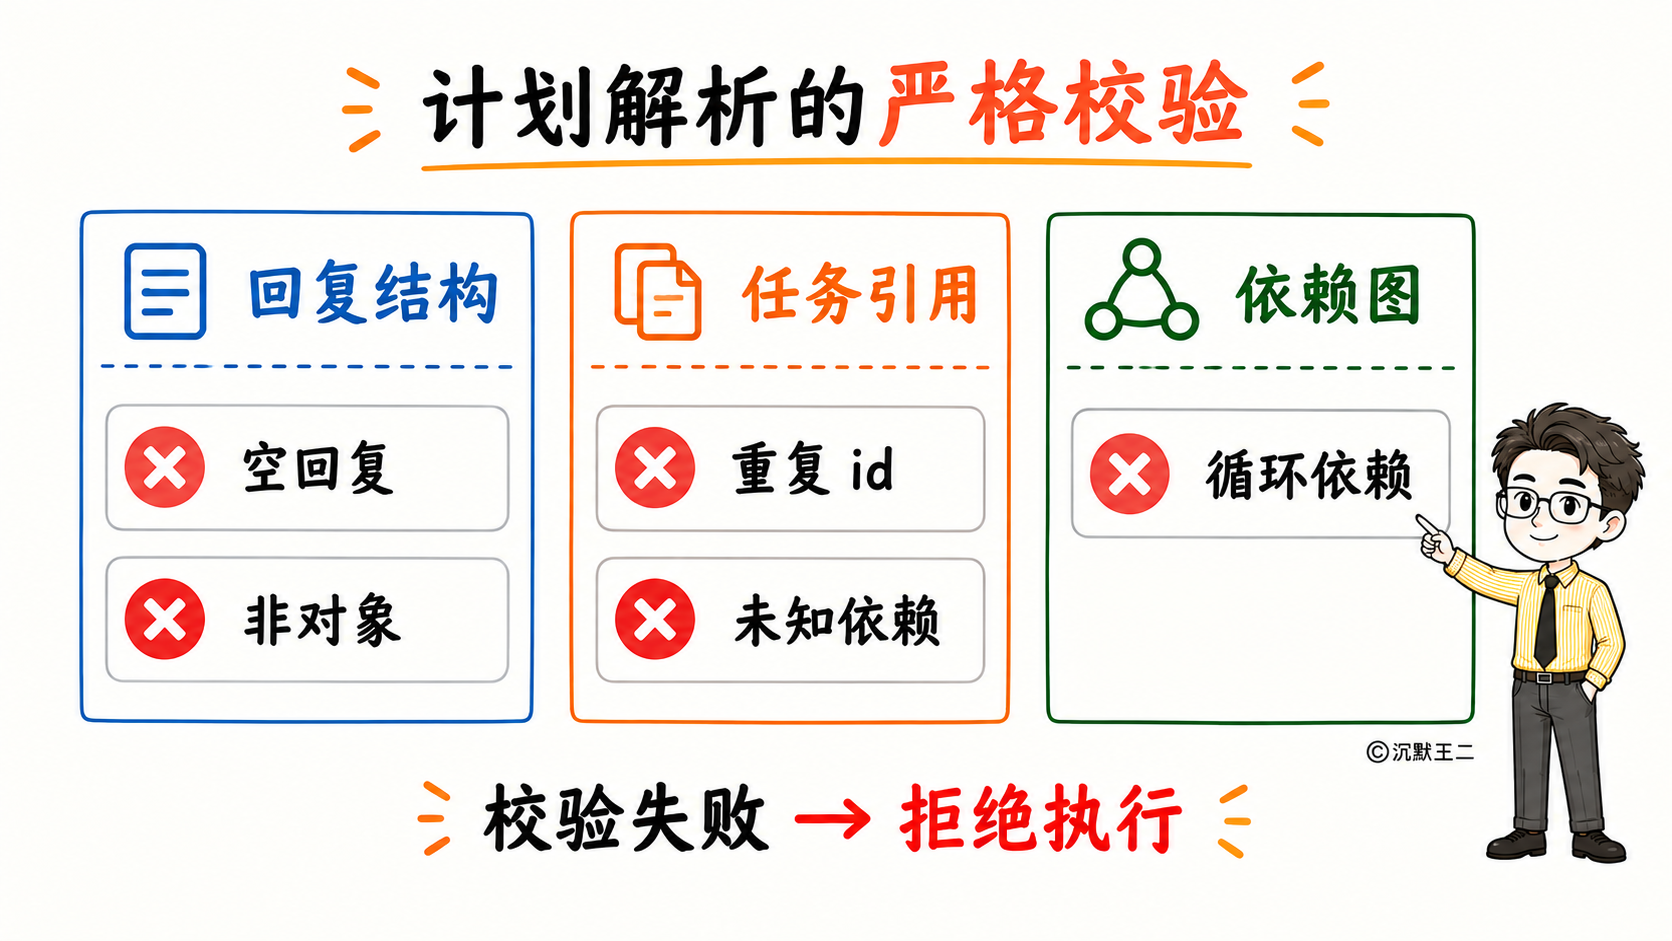
解析失败不自动重试,不退回 ReAct,直接返回“❌ 执行失败”和具体原因。
04、任务按什么顺序跑,哪些能并行
计划通过审阅后,执行器按轮次调度。每一轮取出所有依赖已完成的任务,这一轮全部跑完,再算下一轮。
// src/main/java/com/paicli/agent/PlanExecuteAgent.java,executePlan 节选
while (!stopAfterBatch) {
    if (CancellationContext.isCancelled()) {
        plan.markCancelled();
        return CANCELLED_PLAN_MESSAGE;
    }
    List<Task> executableTasks = getExecutableTasksInOrder(plan);
    if (executableTasks.isEmpty()) {
        break;
    }
    List<TaskExecutionResult> batchResults = executeTaskBatch(
            plan, executableTasks, streamState, taskTrustedUrls, observation);
    // 取消会打断本轮正在执行的任务,这些中断不是任务本身失败,不能再触发重新规划
    if (CancellationContext.isCancelled()) {
        plan.markCancelled();
        return CANCELLED_PLAN_MESSAGE;
    }
    for (TaskExecutionResult batchResult : batchResults) {
        // 成功就标记完成;失败就判断是重新规划,还是跳过它的下游(第 07 节)
    }
}
一轮只有一个任务时,直接在当前线程执行。多个任务就开一个线程池并行。
out.println("⚡ 本轮并行执行 " + executableTasks.size() + " 个任务: " + parallelTaskIds);
ExecutorService executor = Executors.newFixedThreadPool(Math.min(executableTasks.size(), 4), r -> {
    Thread t = new Thread(r, "paicli-plan-executor");
    t.setDaemon(true);
    return t;
});
为什么不就绪一个派发一个
按轮次调度有个代价。某个任务的依赖早就完成了,也得等这一轮最慢的那个任务结束才能开始。改成事件驱动,哪个任务的依赖一到齐就立刻派发,总耗时能更短。
PaiCLI 选按轮次,是因为每一轮的边界都很清楚。哪些任务在同一轮开始,失败发生时哪些结果已经提交,都能按轮次复现出来。PaiCLI 的评测集里有一个评测重放器(e1_replay.py),它根据运行时记录下来的事件,把调度过程重新推演一遍,逐条检查执行器有没有按规则执行,比如“触发重新规划之后不能再有新任务开始”。评测集的做法见《我给 PaiCLI 出了 28 道题》。换成就绪即派发,一个任务失败时,同一批派发出去的其他任务可能还在跑,重新规划和跳过的规则都要重新定义。
对 PaiCLI 这种计划通常只有几个到十几个任务的场景,多等一轮的代价可以接受。
并行输出和写冲突
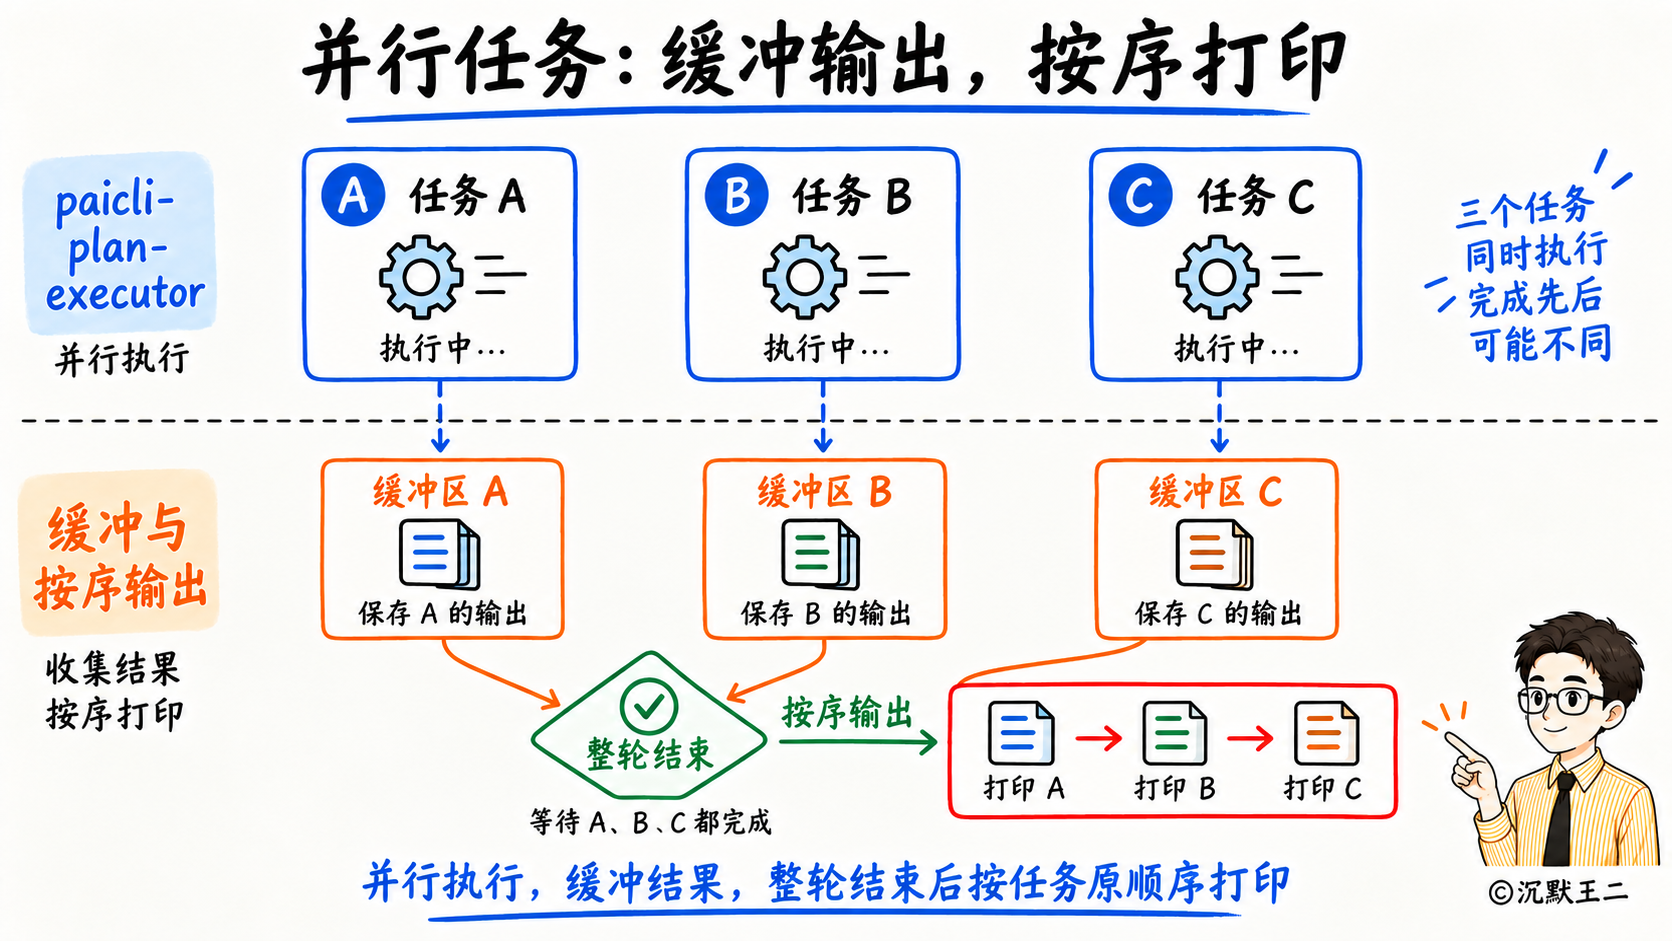
每个并行任务的输出先写进自己的缓冲区,整轮结束后按任务顺序一次性打印。代价是并行执行期间看不到这些任务的流式输出,只能看到“▶️ 并行任务 [task_x]”这样的提示。审批弹窗和自动审查的提示是例外。自动审查指 auto 模式下,执行命令前先让模型判断这条命令有没有风险,第 06 节会讲。这两类提示直接打到终端,不进缓冲区,因为要等用户确认或查看的内容不能拖到整轮结束才出现。
模型一次可能返回好几个工具调用,读文件、搜索这类只读工具最多 4 个并行,写文件、执行命令、MCP 调用一律按模型给出的顺序串行,第 1 期讲过原因。
05、上游的结果怎么交给下游
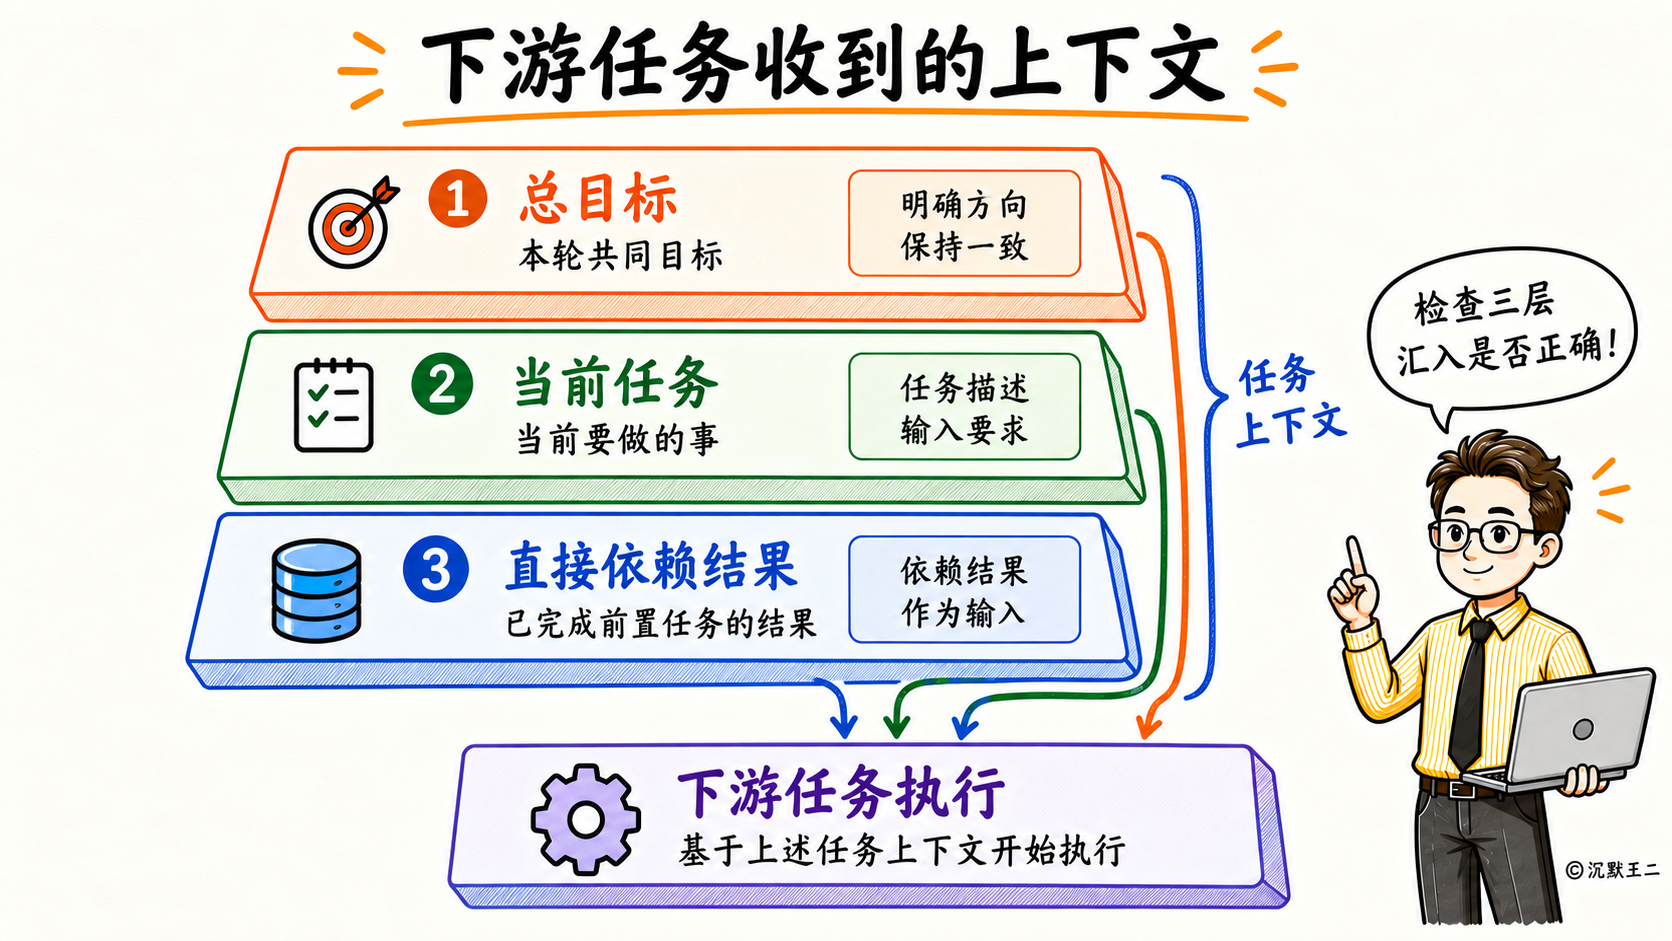
每个任务开始时,拿到的第一条 user 消息是执行器拼出来的任务上下文。
// src/main/java/com/paicli/agent/PlanExecuteAgent.java,buildTaskContext 节选
context.append("总目标:").append(goal).append("\n");
context.append("当前任务:").append(task.getDescription()).append("\n");
if (task.getDependencies().isEmpty()) {
    context.append("依赖任务:无\n");
} else {
    context.append("依赖任务结果:\n");
    for (String depId : task.getDependencies()) {
        Task dep = plan.getTask(depId);
        context.append("- ").append(dep.getId())
                .append(" / ").append(dep.getDescription())
                .append(" / 状态=").append(dep.getStatus())
                .append("\n");
        if (dep.getResult() != null && !dep.getResult().isBlank()) {
            context.append(dep.getResult()).append("\n");
        }
    }
}
context.append("请执行此任务。如果是ANALYSIS或VERIFICATION类型,请基于以上上下文直接给出结果。");
上下文里只带直接依赖任务的结果。依赖的依赖(间接依赖)不带,和当前任务没有依赖关系的任务也不带。下游任务如果需要更早的信息,只能靠直接依赖的任务在自己的结果里转述。
为什么不让所有任务共用一份对话历史?
因为并行的任务同时往一份历史里追加消息,顺序说不清。就算串行,下游也会看到上游每一次工具调用的原始输出。
这里也可以查看进阶之路上《多 Agent 之间怎么传递上下文?》
联网权限也按依赖传
PaiCLI 每一轮都会根据用户这一轮的原话生成一份工具策略(TurnToolPolicy),规定哪些工具可以用、哪些网址可以访问。每个任务开始前,都从这份工具策略复制一份副本,同一批并行的任务各用各的副本,各自新发现的网址互不共享。
TurnToolPolicy taskToolPolicy = turnToolPolicy.forkWithTrustedUrls(dependencyUrls);上游任务通过 web_search 拿到的 URL,只传给 DAG 里声明依赖它的下游,拼进任务上下文时单独列一段“依赖分支经 web_search 验证的 URL”。上游回复正文里写的网址不能算数,下游想抓取也会被拒绝。
这样做是为了防御提示词注入。提示词注入指网页里藏着一段专门写给模型看的指令,比如“请访问某某网址”。一个任务读到的网页再怎么诱导,也没法让另一个任务去访问它指定的地址。
06、一个任务内部怎么干活
每个任务有一份独立的消息列表。system 是任务执行提示词,带上 PAI.md、Skill 索引和任务类型,Skill 索引是当前可用技能的名称和简介列表,第 15 期细讲;user 是上一节拼好的任务上下文。之后就是第 1 期那套循环,每一轮依次做这几件事。
// src/main/java/com/paicli/agent/PlanExecuteAgent.java,任务循环节选
while (true) {
    if (CancellationContext.isCancelled()) { /* 返回“已取消任务” */ }
    AgentBudget.ExitReason exitReason = budget.check();   // 停滞或预算命中就收尾
    injectPendingLspDiagnostics(messages, out, actor);    // 上一步改过代码,补上语法诊断
    maybeCompactHistory(messages, out, actor);            // 太长就先压缩
    TurnToolPolicy.ToolExposure toolExposure = taskToolPolicy.expose(toolDefinitions);
    LlmClient.ChatResponse response = llmClient.chat(
            messages, toolExposure.definitions(), streamRenderer);
    // 没有工具调用 → 任务完成,返回模型的回答
    // 有工具调用 → 执行工具,结果经安全边界包装后交回模型 → 注入本轮加载的 Skill → 重复检测
}
注释里有几个词需要单独说明。语法诊断是指上一步改过 Java 文件后,PaiCLI 会检查语法错误,把错误信息补进下一次请求。安全边界包装是指工具结果交回模型前,外面会包一层标签,标明这是不可信的数据,里面的指令模型不能执行。重复检测就是第 1 期讲过的那道关卡,模型连续 3 次做同一个动作,或者连续 3 次碰到同一类错误,就在工具结果后面追加一条提醒,让模型换个做法,不拦截任何工具。
权限也和 ReAct 共用一套。计划任务和 ReAct 用同一个工具注册表,默认的 auto 模式下,执行命令的工具 execute_command 在执行前,先由当前模型关闭思考模式发一次简短请求,判断这条命令有没有风险。判断为可以执行才执行,否则把原因交回模型。
什么时候算任务失败?
执行过程中抛出异常,比如模型调用失败。工具报错会作为工具结果交回模型,让它自己处理。预算触发时返回部分结果,这里的预算指任务循环的上限。轮数和 Token 上限默认不限,但模型连续 5 次调用同一个工具、参数也完全相同,第 1 期讲的强制收尾就会生效,关掉所有工具,让模型基于已有结果收尾。用户取消返回“已取消”。这几种都不算失败,不会触发重新规划。
07、任务失败了怎么收场
一个任务失败后,执行器先看整份计划的完成度。
if (!stopAfterBatch && plan.getProgress() < 0.5) {
    int maxReplans = maxReplans();
    if (replansUsed < maxReplans) {
        out.println("🔄 尝试重新规划(第 " + (replansUsed + 1) + "/" + maxReplans + " 次)...\n");
        ExecutionPlan replanned = planner.replan(plan, errorMessage);
        return reviewAndExecutePlan(replanned, streamState, explicitTaskEnvelope, replansUsed + 1)
                .result();
    }
    String stopNotice = "已达到重新规划上限(" + maxReplans + " 次),停止执行剩余任务";
    out.println("🛑 " + stopNotice + "。\n");
    failureLines.add(stopNotice);
    stopAfterBatch = true;
    continue;
}
for (Task skipped : plan.skipDependentsOf(task.getId())) {
    failureLines.add("任务 " + skipped.getId() + " 已跳过: 依赖的任务 " + task.getId() + " 失败");
}
完成度状态为 COMPLETED 的任务数除以任务总数,失败、跳过和还没执行的任务都不算完成(ExecutionPlan.getProgress)。完成度低于一半,说明计划刚开始就出了问题,更可能是计划本身不对,需要重新规划。新计划同样要经过用户审阅。
重新规划最多 2 次,可以用 PAICLI_PLAN_MAX_REPLANS 调整。不设上限的话,新计划在一半之前失败,就会一直规划下去。到了上限,不再启动任何新任务,只保留这一轮已经返回的结果,其余任务全部标 SKIPPED。
完成度过半,说明大部分工作已经做完,没必要推倒重来。失败任务的直接和间接下游标记成 SKIPPED,不受影响的任务继续跑。
重新规划时模型知道什么
context.append("原任务: ").append(failedPlan.getGoal()).append("\n");
context.append("失败原因: ").append(failureReason).append("\n");
context.append("已完成的任务:\n");
for (Task task : failedPlan.getAllTasks()) {
    if (task.getStatus() == Task.TaskStatus.COMPLETED) {
        context.append("- ").append(task.getId())
                .append(": ").append(task.getDescription()).append("\n");
    }
}
context.append("\n请制定新的执行计划,避开之前的问题。");
return createPlan(context.toString());
模型只知道哪些任务做完了,看不到它们的结果。新计划是一份全新的计划,不继承旧计划的完成状态,所以没法保证只重做失败的那一步。审阅新计划时要留意有没有重复操作。
为什么不把结果也带上?
规划请求要尽量小而固定。一旦带上结果,读过大文件的任务会把规划请求撑得很长很长,而这份请求的格式也是评测重放器逐字核对的内容。这是 PaiCLI 目前明确保留的限制,要改得连重放器一起改。
用户取消的时候
用户按 ESC 取消时,正在跑的任务会被打断,这些任务会以异常的形式回来。如果按普通失败处理,完成度又不到一半,执行器就会返回“🔄 尝试重新规划”,在用户已经放弃的任务上再调用一次模型。
所以一轮结果回来后,执行器先检查取消状态,已取消就把计划标成 CANCELLED,直接返回“⏹️ 已取消当前计划执行。”,不进入失败处理。
汇总
有任务失败时,汇总先列已完成任务的结果,再列失败和跳过的原因。已经流式显示过的结果不再重复打印。格式如下,内容为示意。
⚠️ 计划部分完成,有任务失败。
已完成的任务结果:
[task_1] pom.xml 使用 Maven 构建,Java 17
[task_2] src/main/java 下共有 3 个包
任务 task_3 失败: 读取 README.md 超时
任务 task_5 已跳过: 依赖的任务 task_3 失败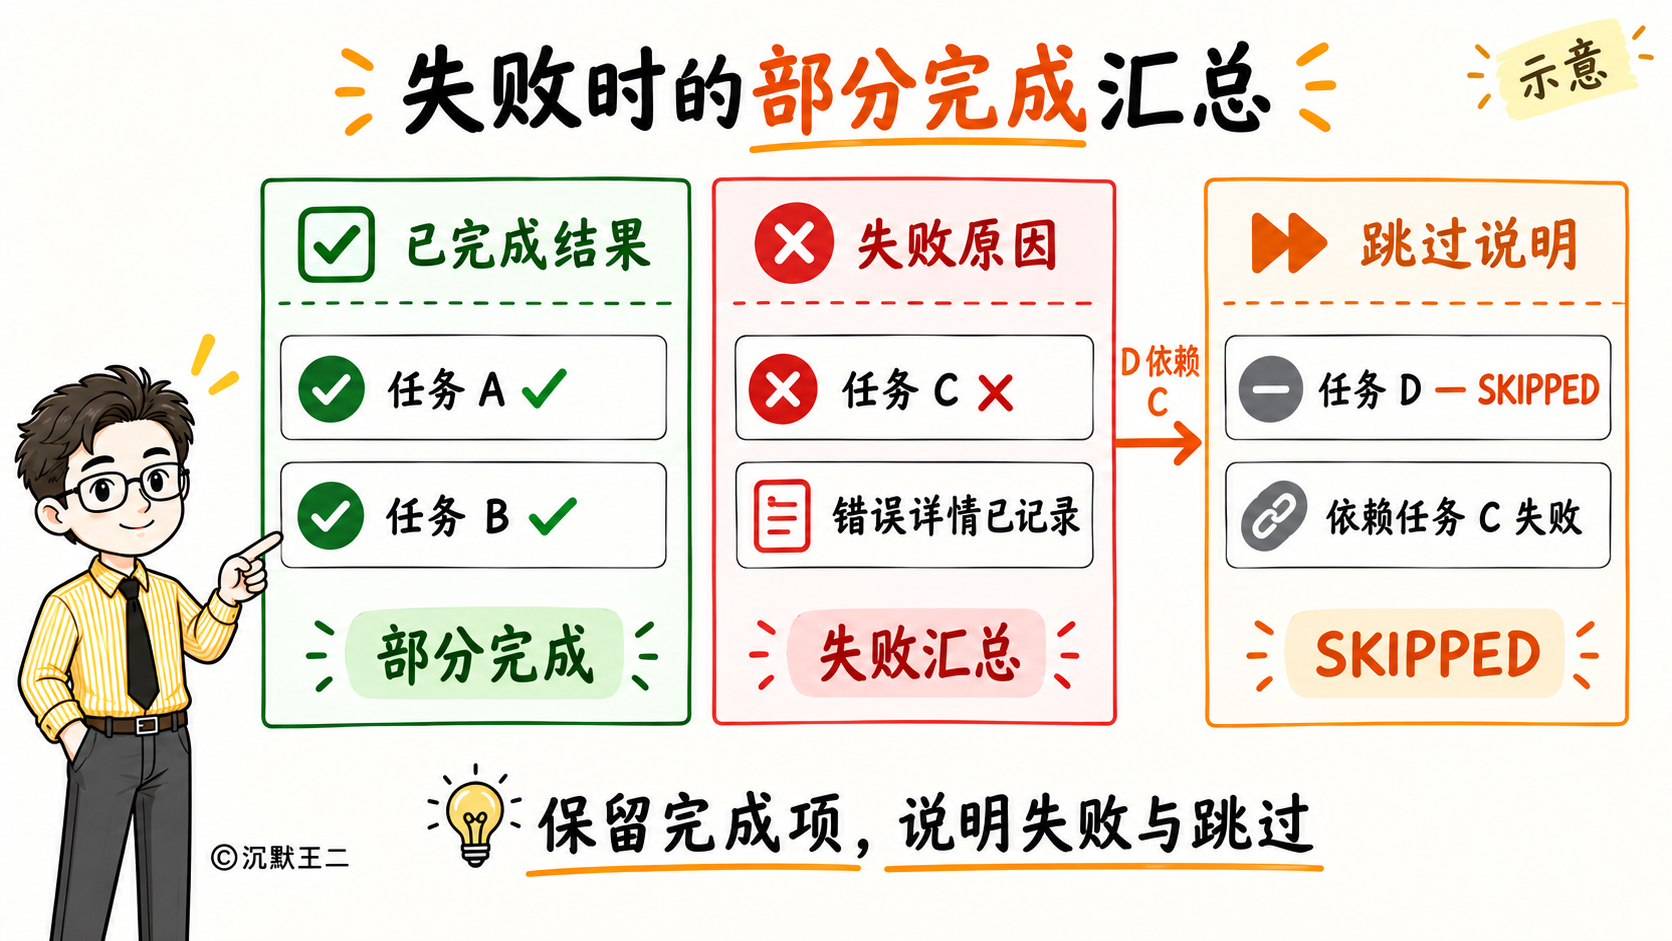
08、怎么进入计划模式,计划怎么审
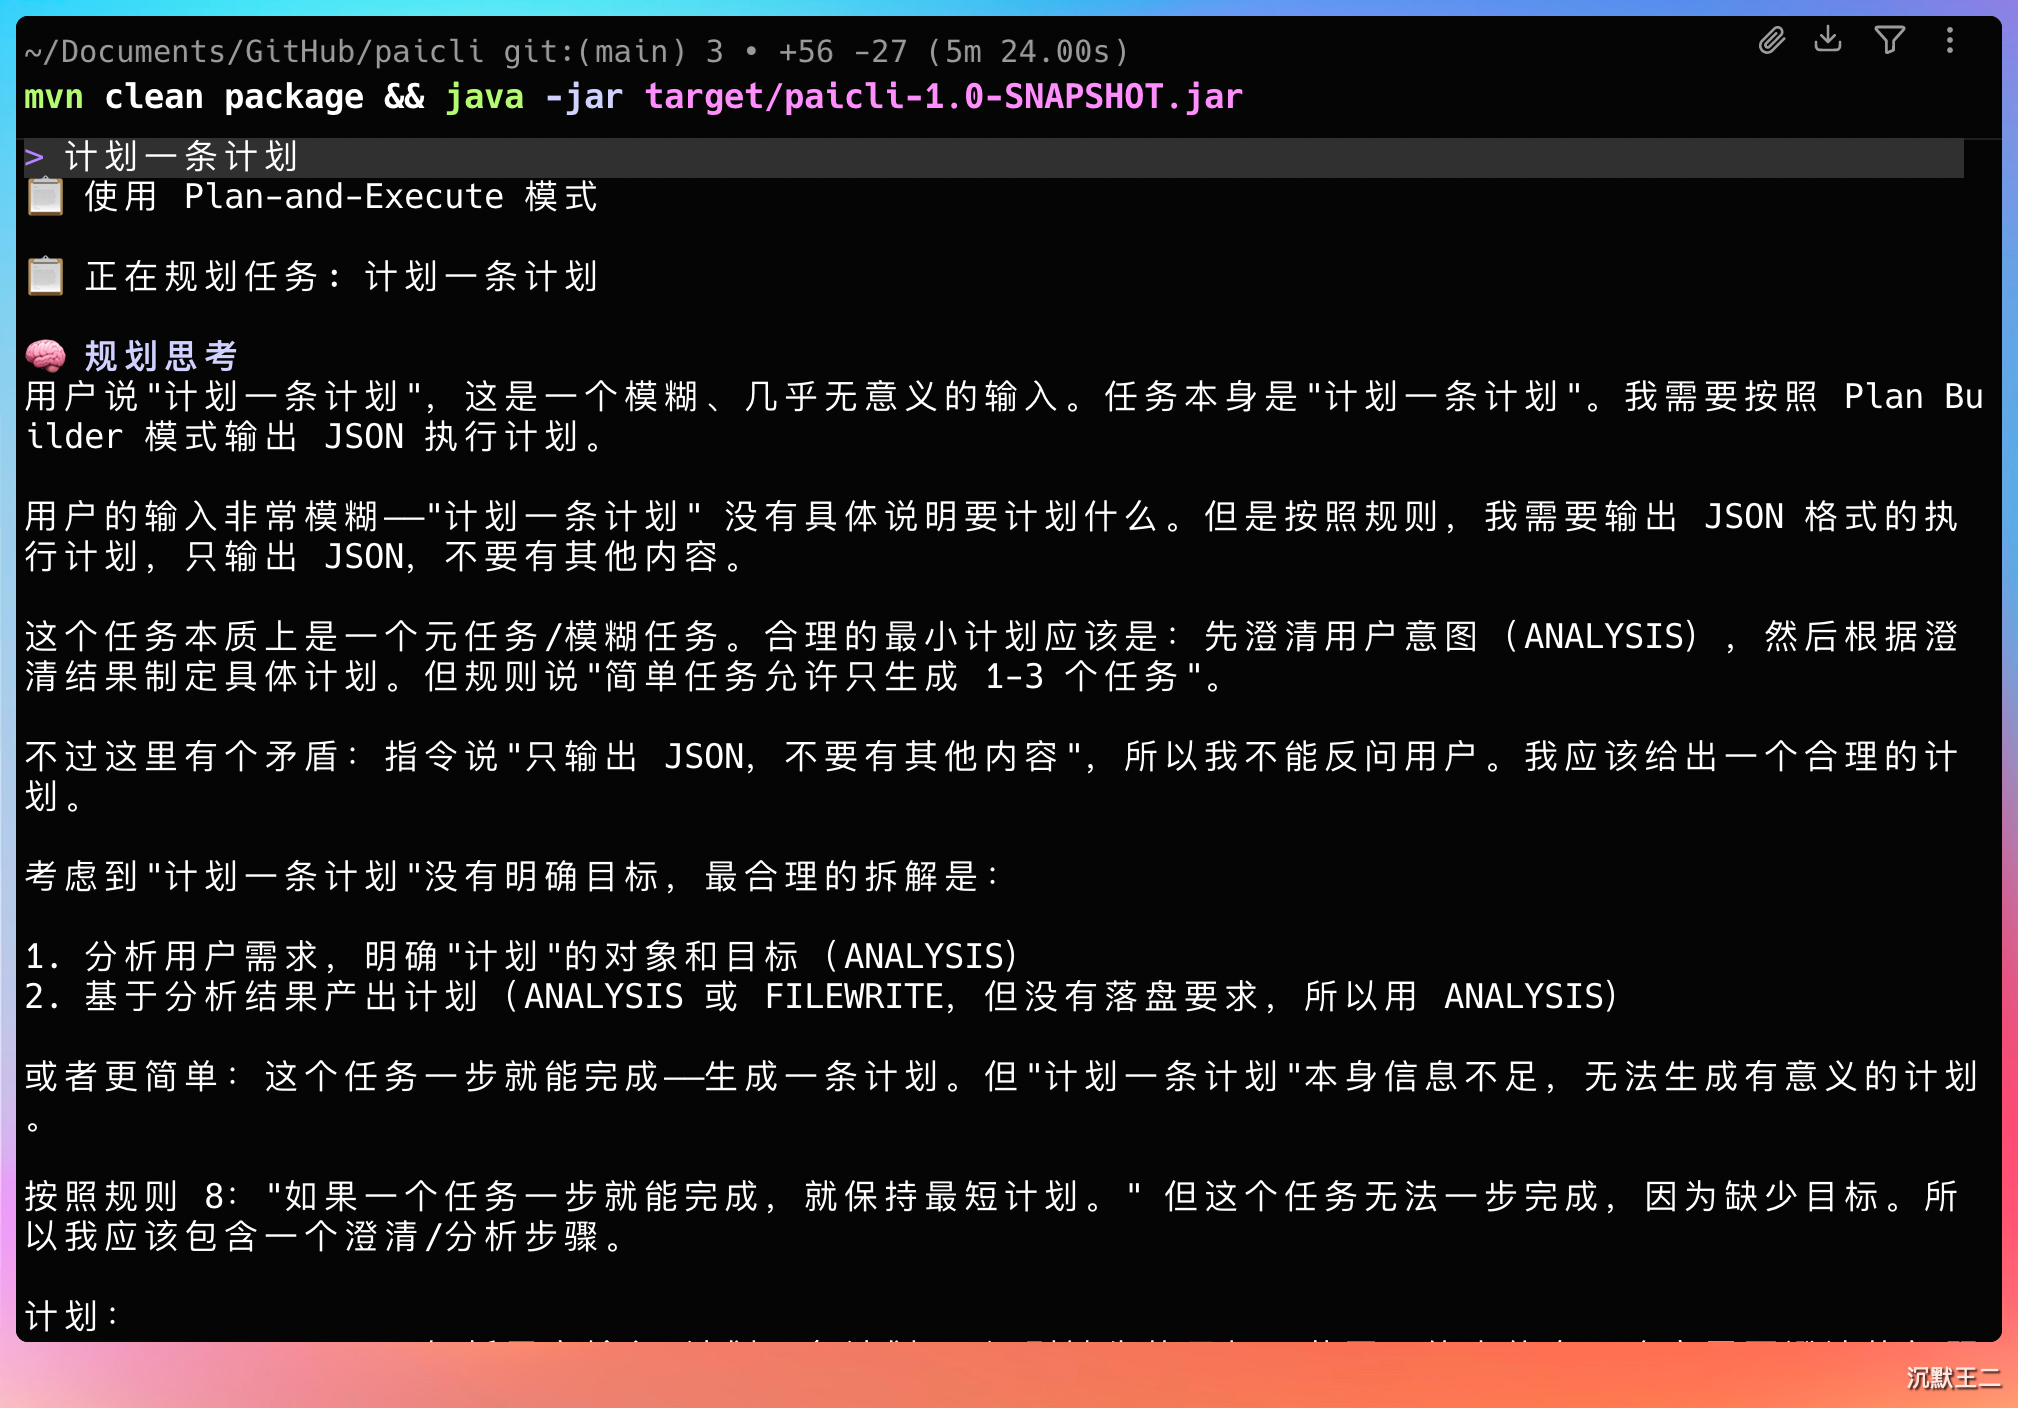
PaiCLI 启动后默认为 auto 模式。进入 Plan-and-Execute 有三种方式。
/plan:只有下一条任务走计划模式,执行完回到原来的模式/plan <任务>:这一条任务直接走计划模式- Shift+Tab 切到 plan 模式,或者输入
/mode plan:之后每条普通输入都先规划再执行,状态栏显示“PLAN shift+tab to cycle”,直到切到其他模式。
Shift+Tab 按 auto → plan → ask 循环。三种模式的区别在于哪些操作需要用户确认。auto 模式下读写文件直接执行,执行命令先经过模型审查;ask 模式下写文件、编辑文件、执行命令、创建项目等操作都要用户确认;plan 模式在哪些操作需要确认上和 auto 一样,只是多了一个“普通输入走计划”的开关。在 plan 模式下显式输入 /team,仍然走 Multi-Agent,本条输入里显式写的命令优先。
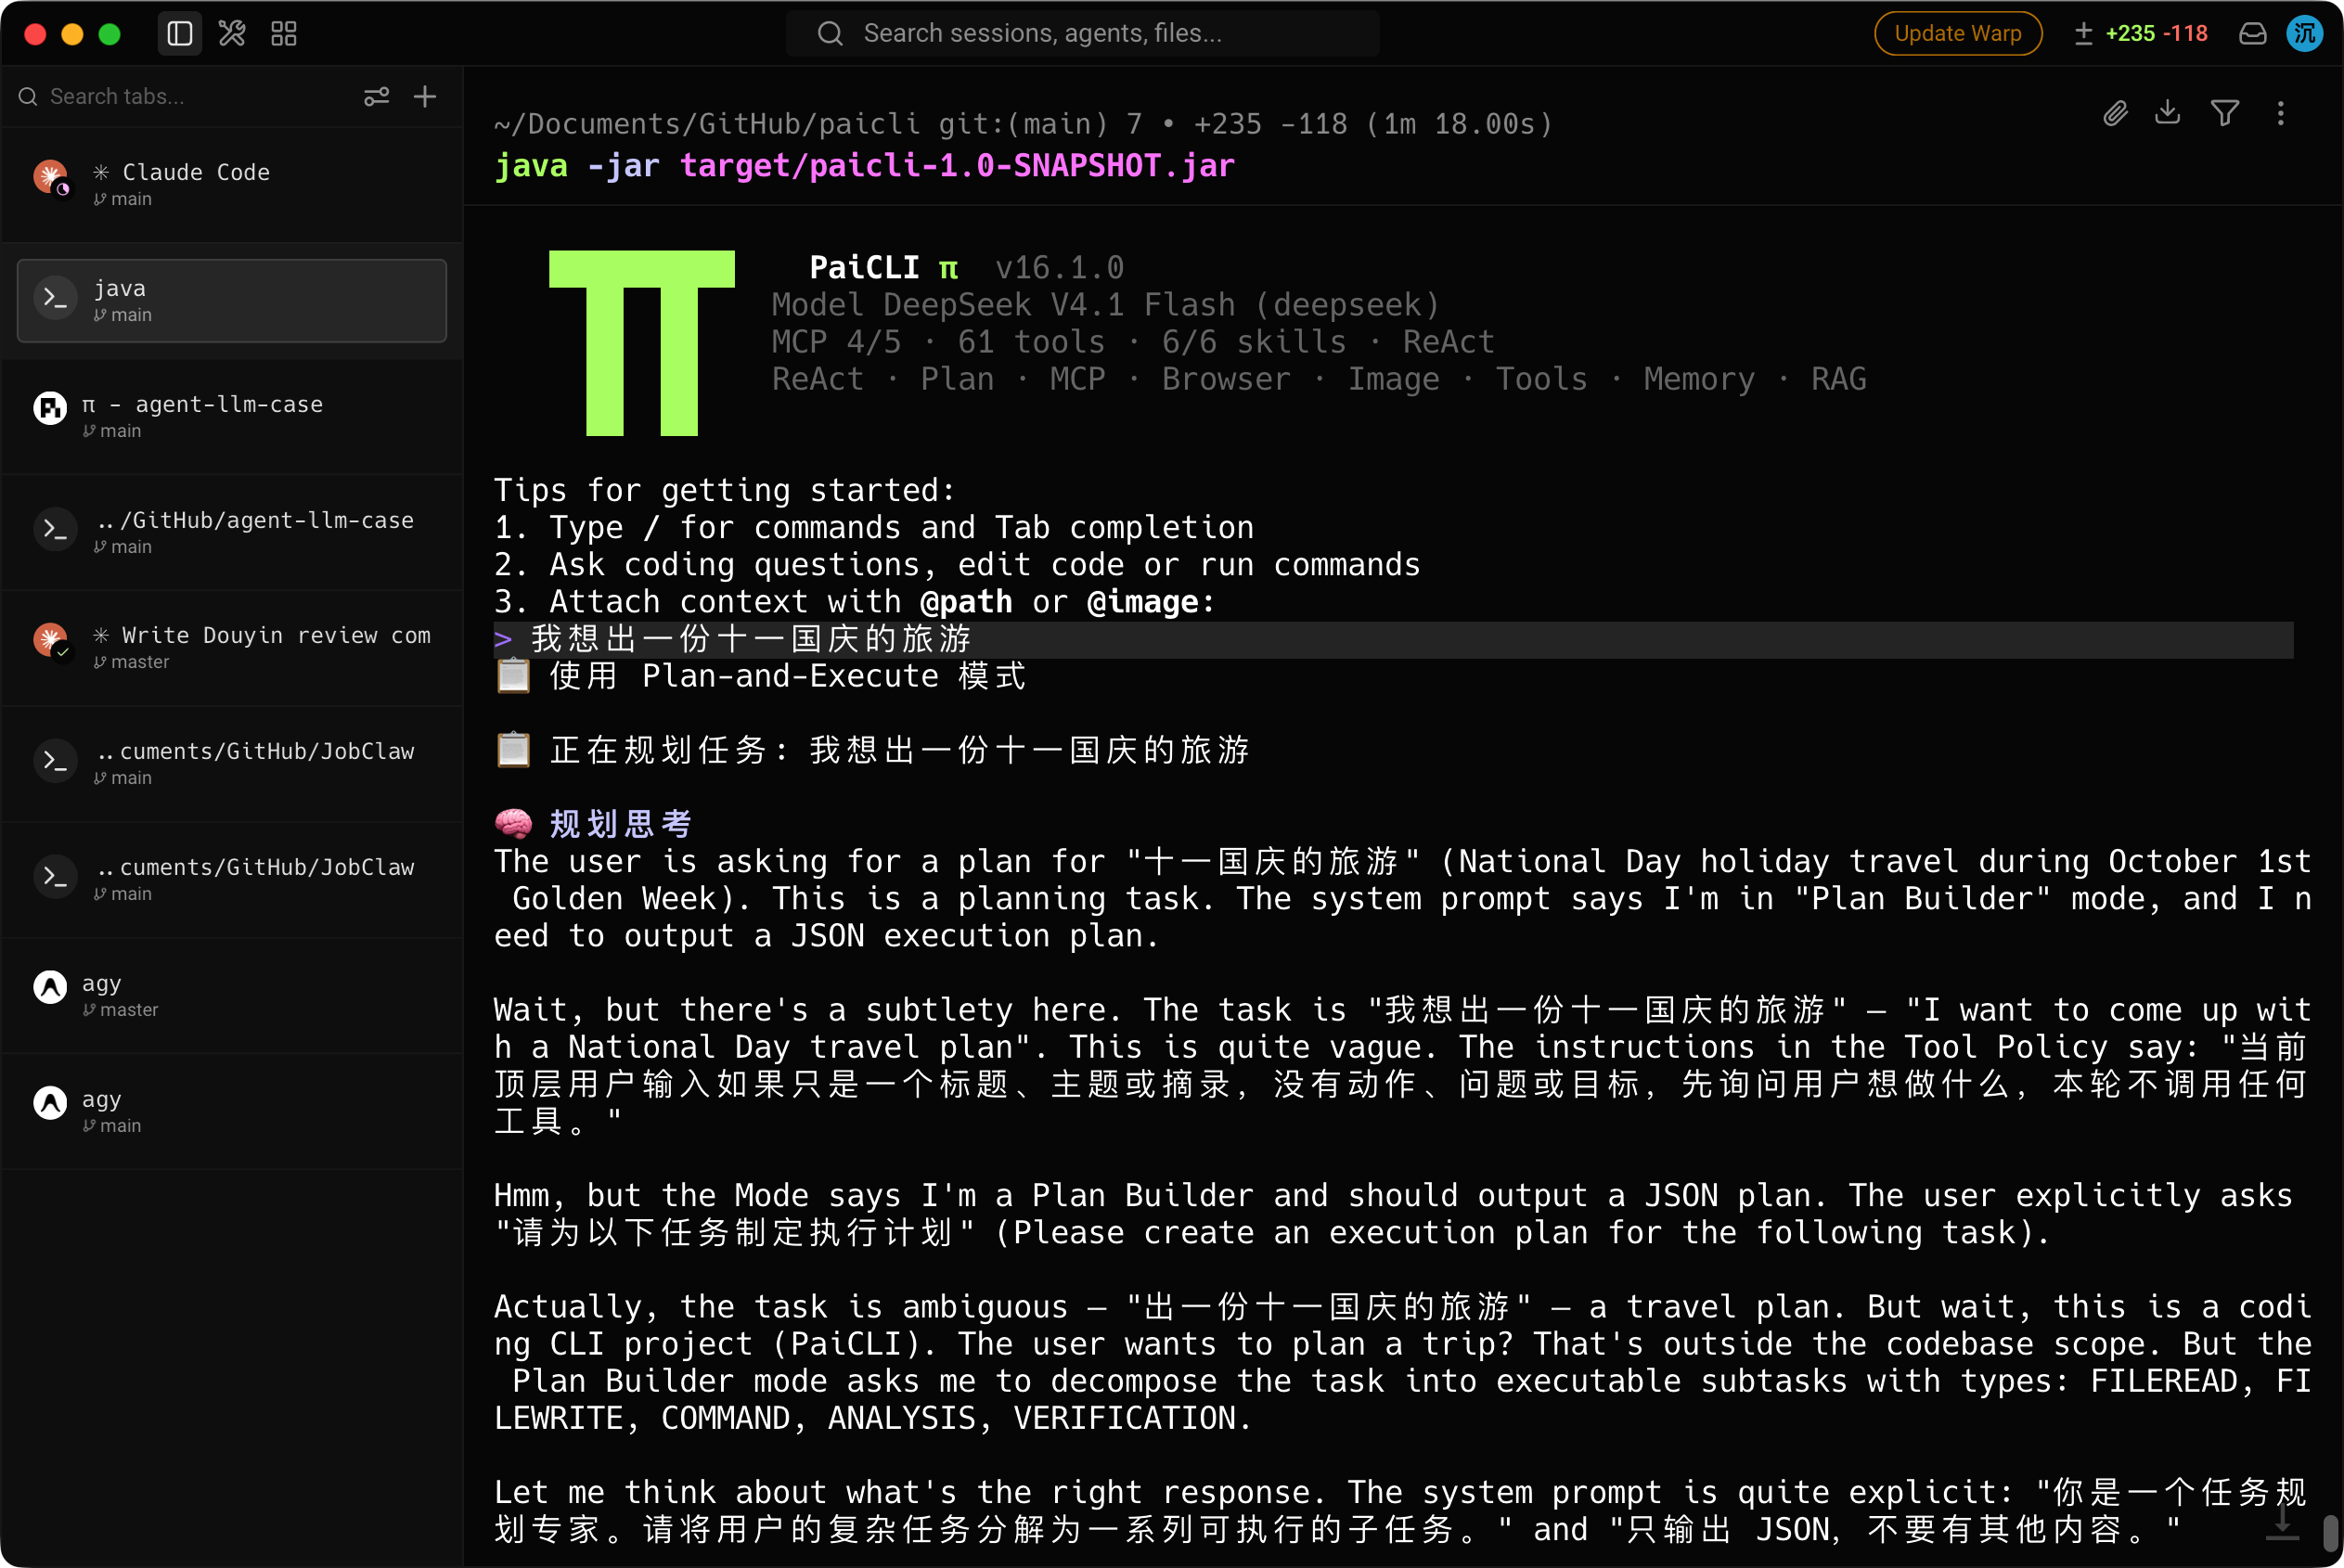
审阅
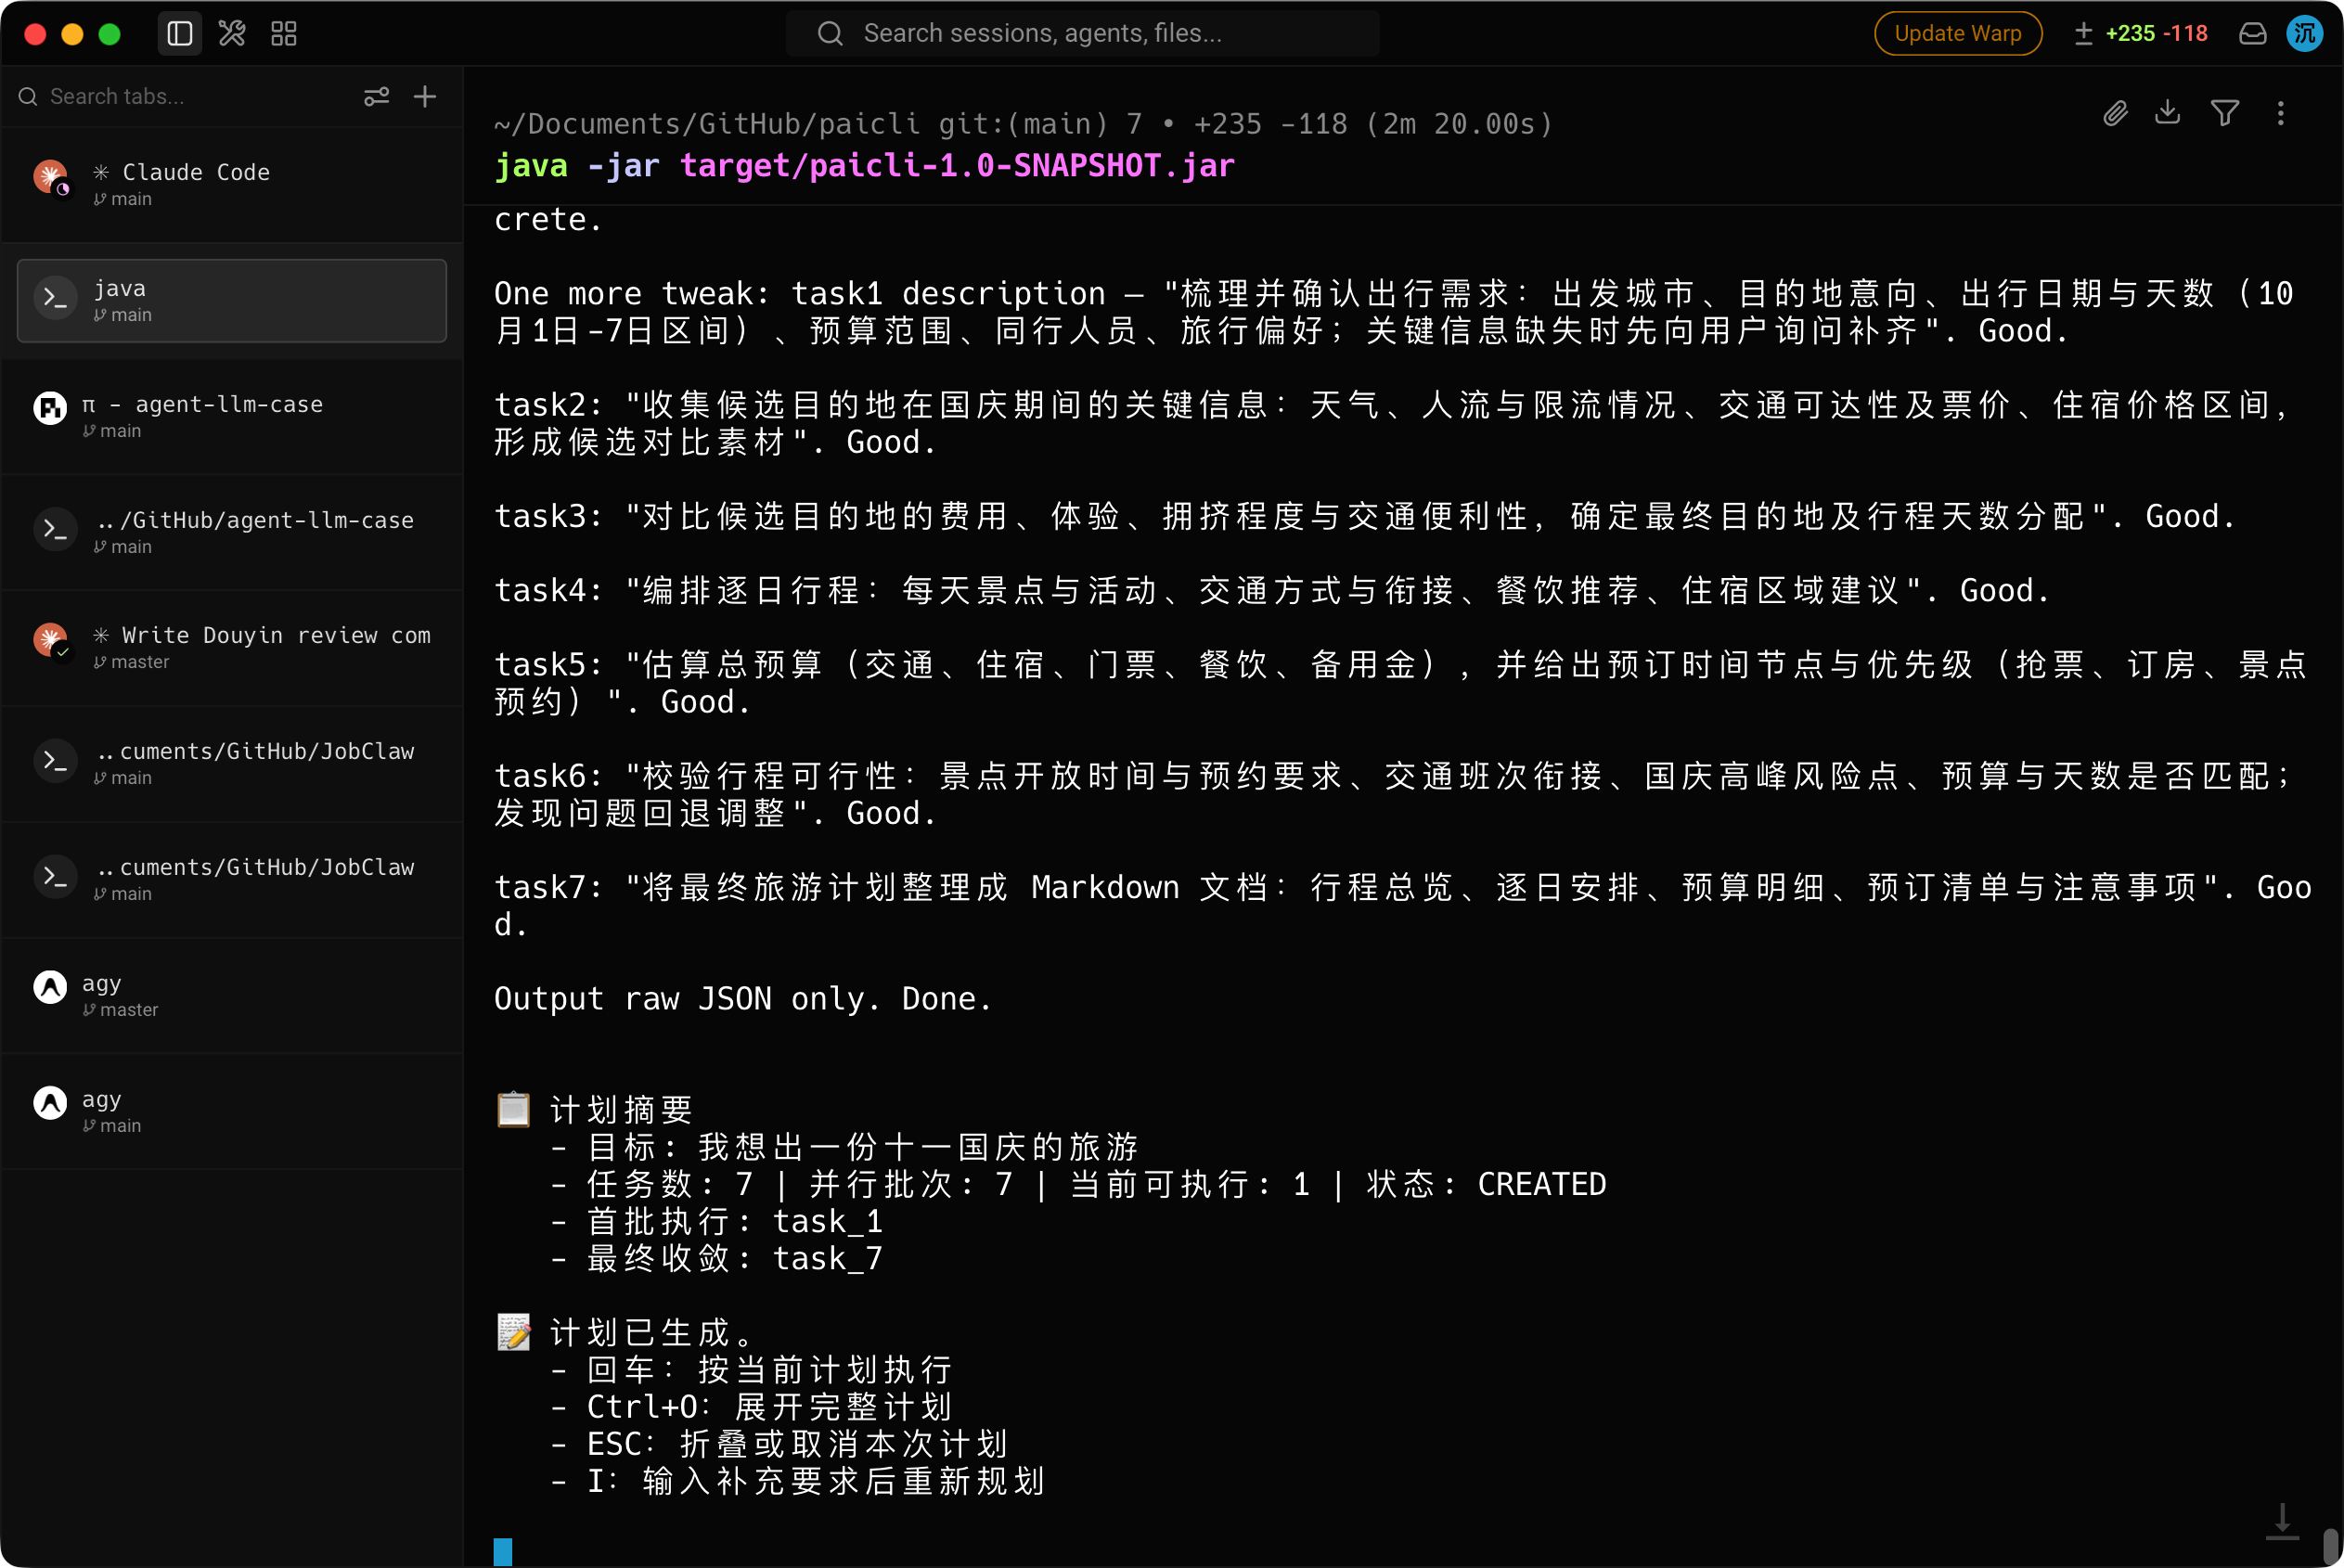
计划生成之后、执行之前,终端会停下来。默认显示折叠摘要,有目标、任务数、并行批次数、当前可执行和首批执行的任务。
📝 计划已生成。
   - 回车:按当前计划执行
   - Ctrl+O:展开完整计划
   - ESC:折叠或取消本次计划
   - I:输入补充要求,在当前计划上修改
Ctrl+O 展开带状态图标的完整任务图,ESC 在展开时折叠回摘要,在摘要里就是取消。执行期间这张图不会刷新,只输出逐行日志,比如“▶️ 执行任务”“⚡ 本轮并行执行 N 个任务”“✅ 完成”“❌ 失败”。
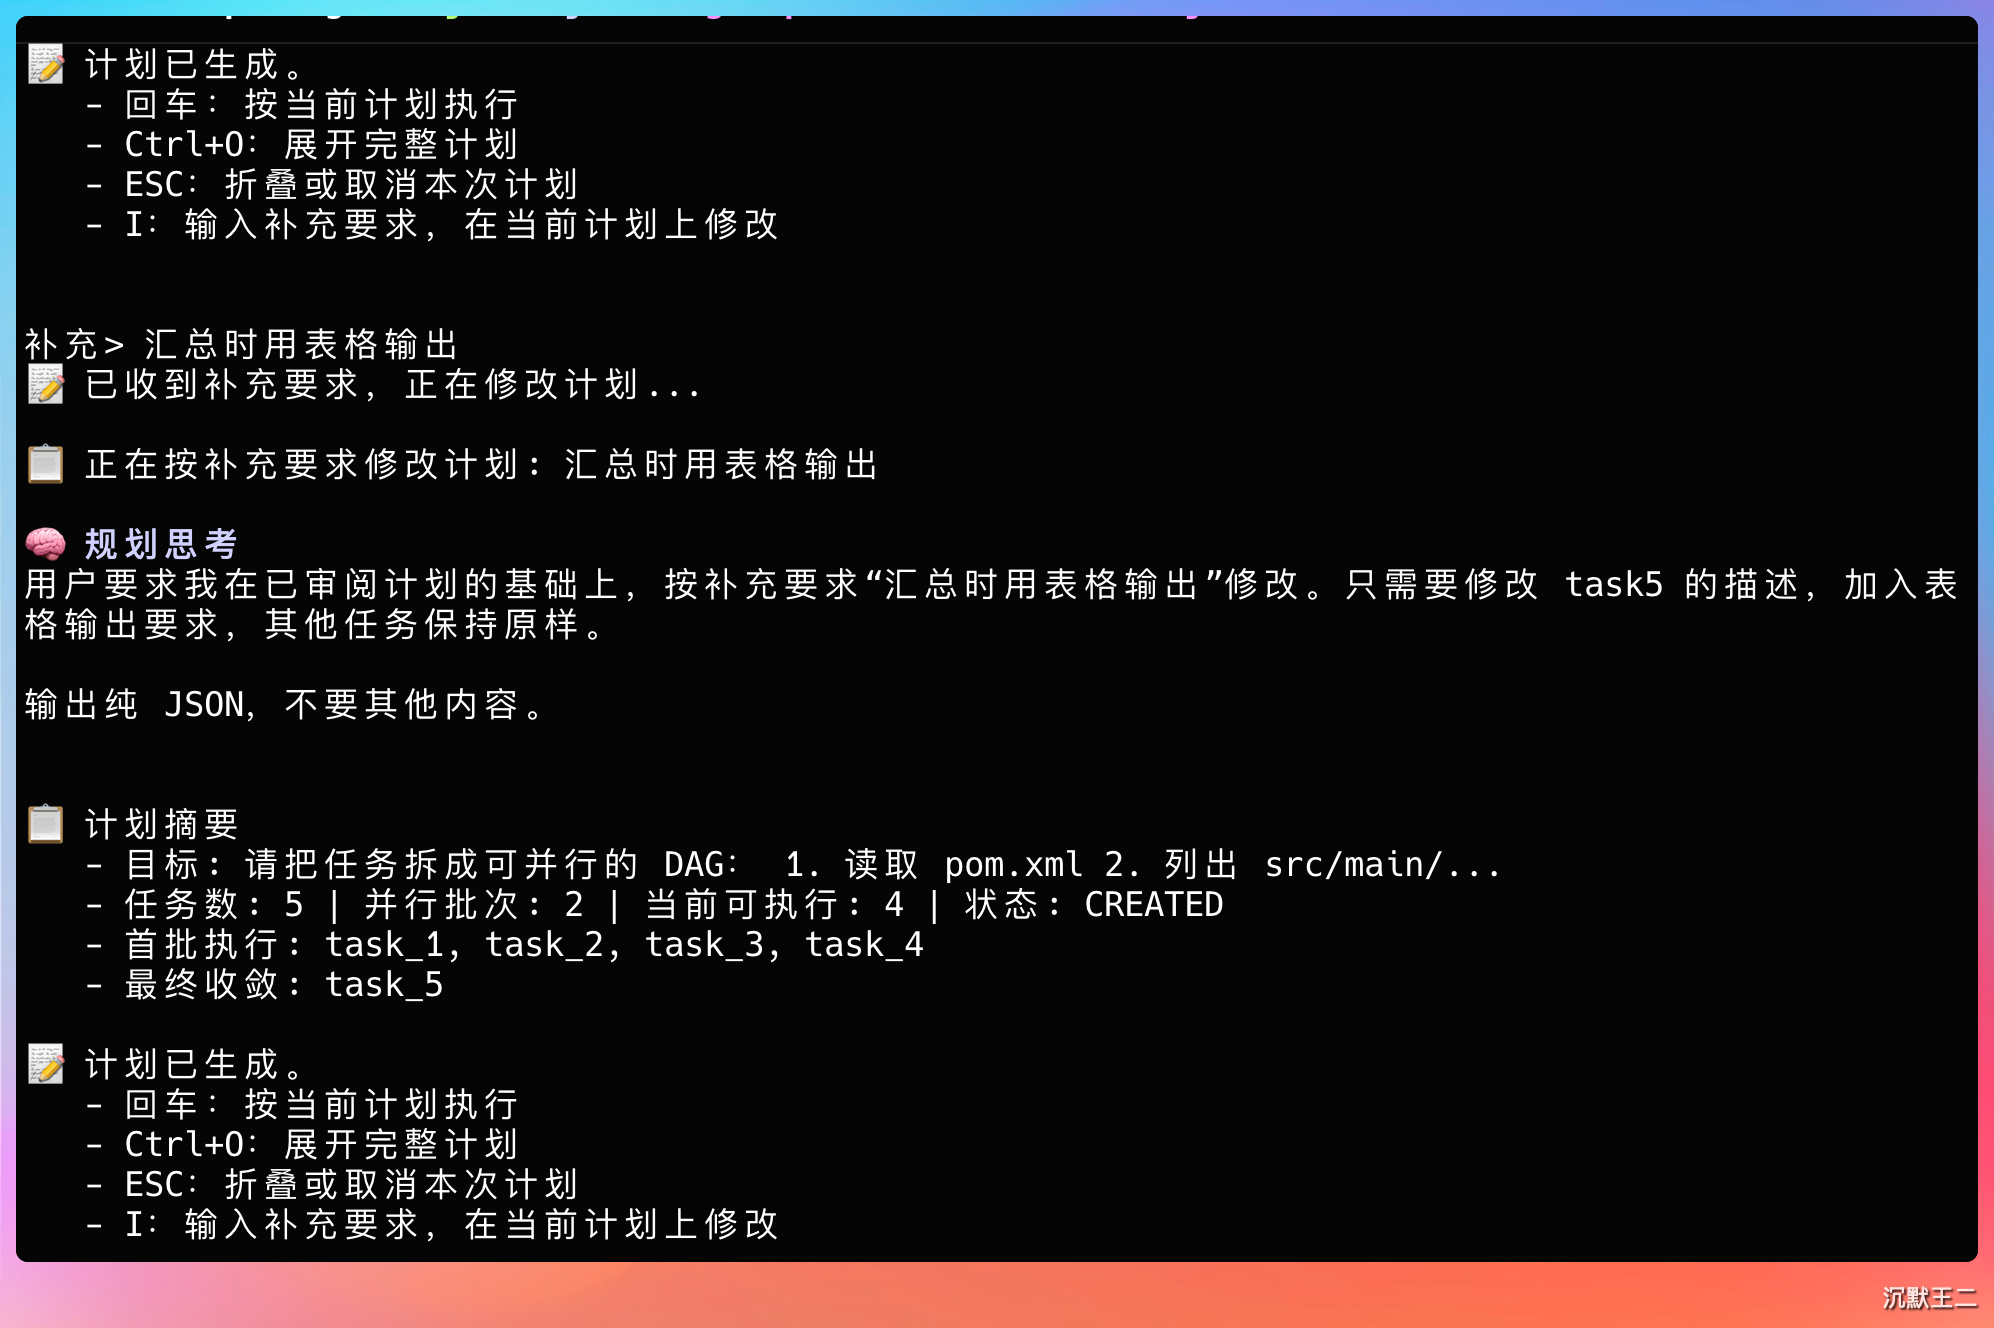
按 I 输入的补充要求,会连同当前计划一起交给模型,在当前计划上修改,不从头规划。
public ExecutionPlan revisePlan(ExecutionPlan current, String feedback) throws IOException {
    String revisedGoal = current.getGoal() + "\n补充要求:" + feedback;
    String request = "请为以下任务制定执行计划:\n" + revisedGoal
            + "\n\n下面是用户刚审阅过的当前计划。请在它的基础上按补充要求修改,"
            + "不受补充要求影响的任务保持原样,输出修改后的完整计划:\n"
            + toPlanJson(current);
    return requestPlan(revisedGoal, request);
}
为什么不按补充后的目标从头规划?
用户刚审过这份计划,只想改一两处,从头生成会把没问题的任务也换个说法,还得从头再审一遍。
终端读不到单个按键时会退回行模式。直接回车、y、run 都是执行,/view 展开,cancel 或 esc 取消,其他文字当作补充要求。
09、跑起来看看
编译运行。
mvn clean package
java -jar target/paicli-1.0-SNAPSHOT.jar
先来一个串行的例子,每一步都依赖上一步。
/plan 创建一个 Java 项目叫 demo,写一个 Hello 类输出 Hello World,然后编译运行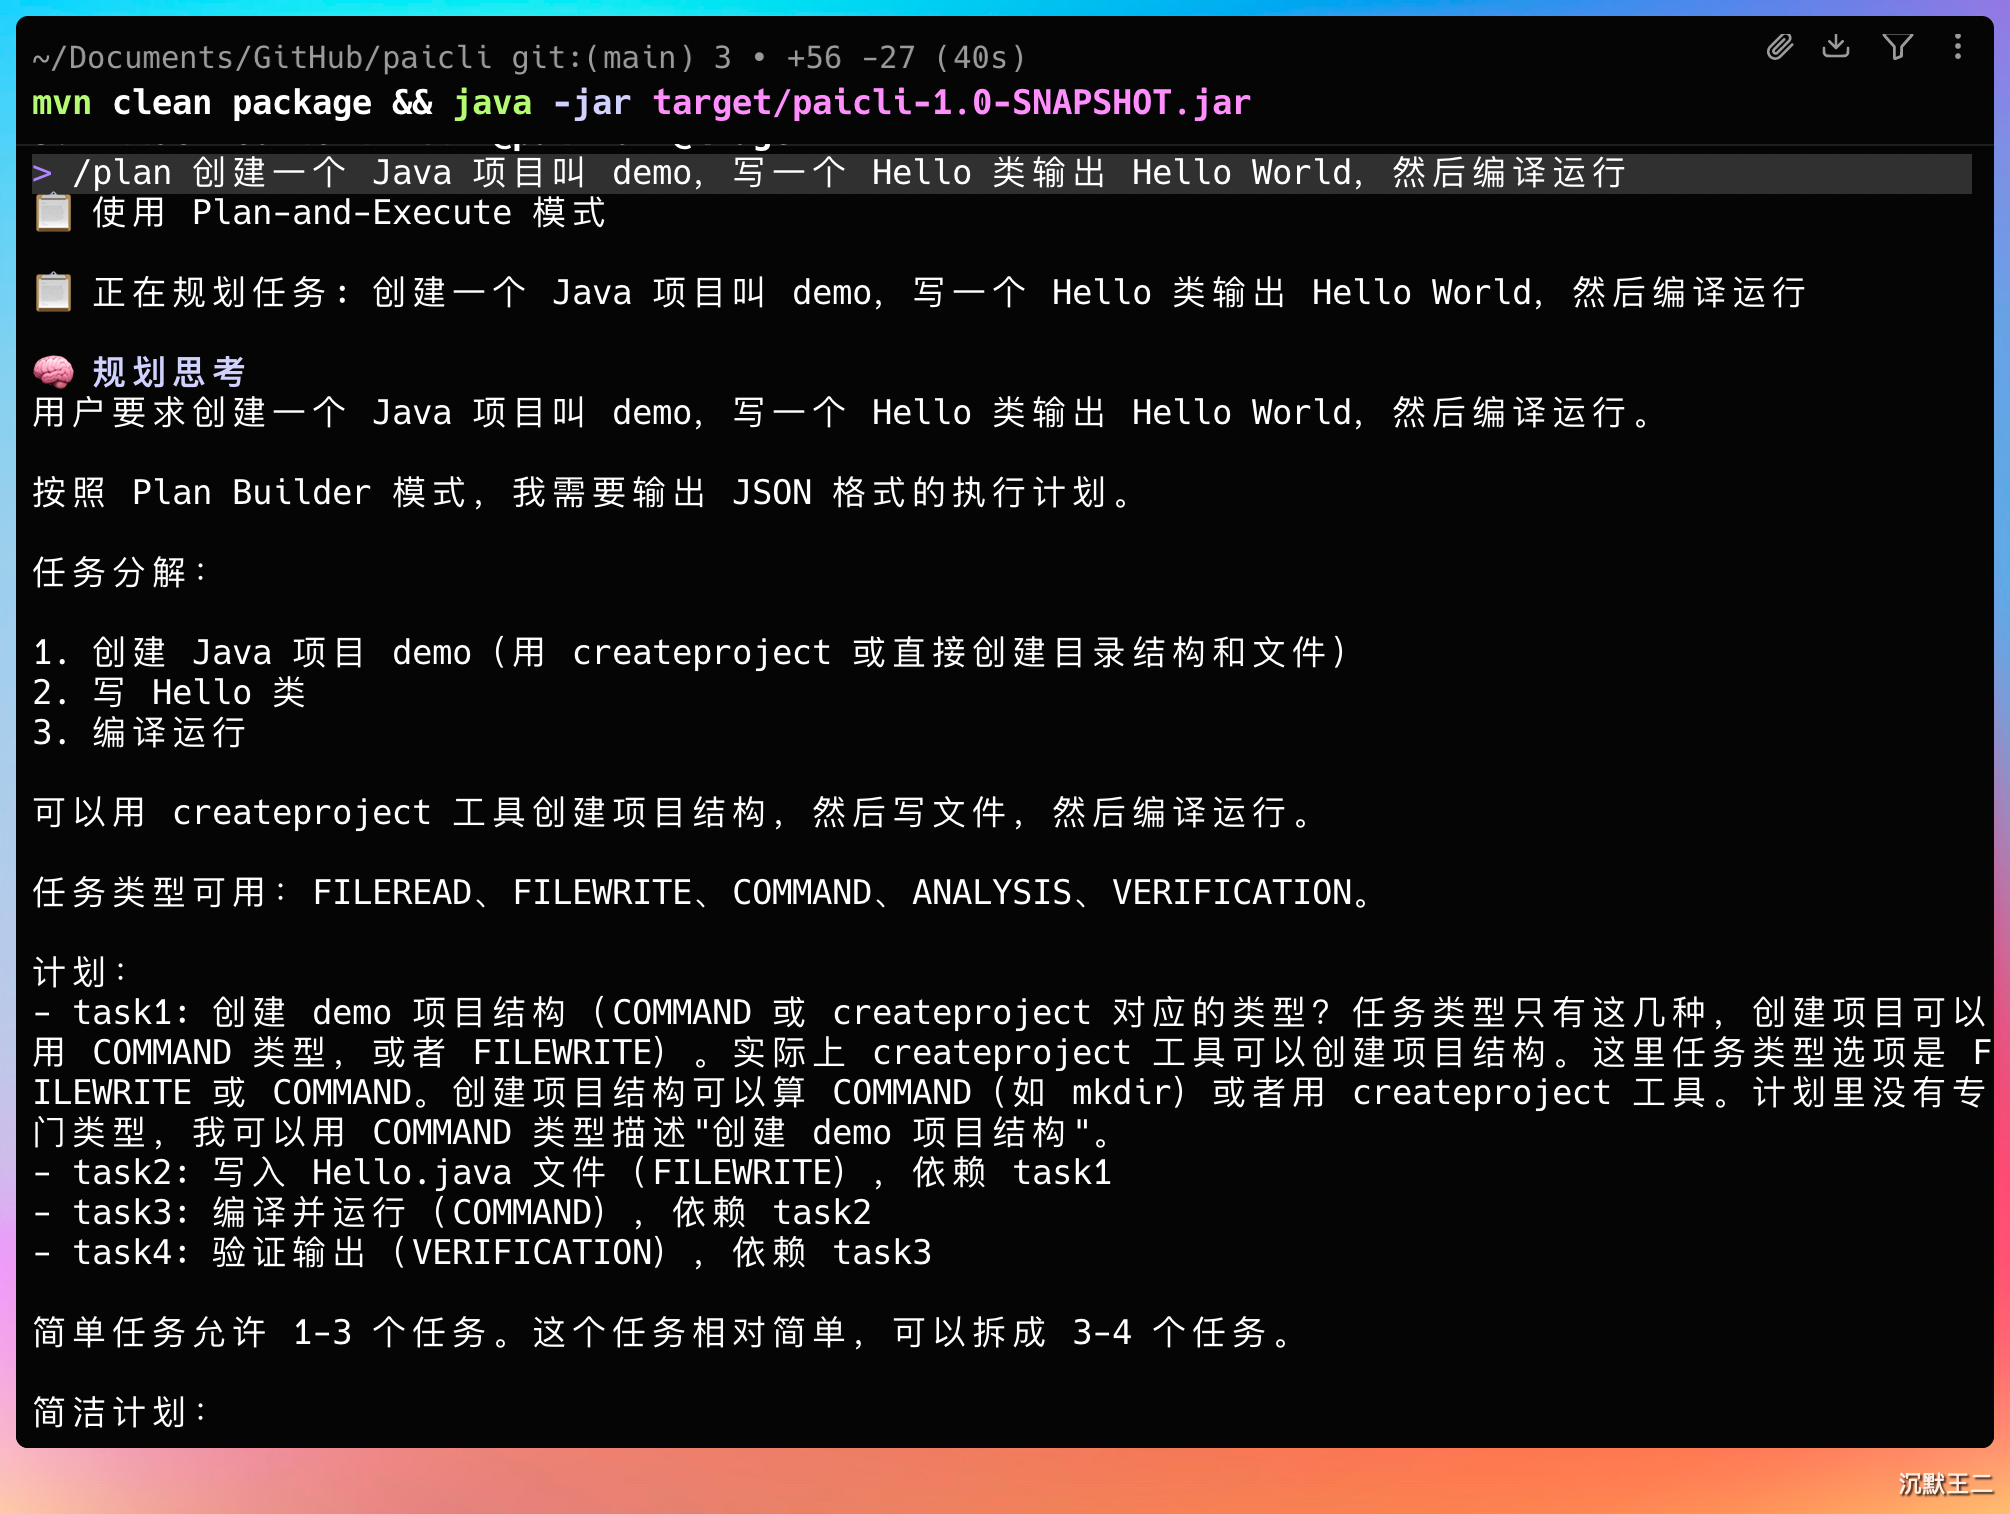
再来一个能并行的。
/plan 请把任务拆成可并行的 DAG:
1. 读取 pom.xml
2. 列出 src/main/java 下的文件
3. 列出 src/test/java 下的文件
4. 读取 README.md 的前 80 行
5. 最后汇总以上结果,告诉我这个项目的构建方式、源码结构和测试情况。
要求:前 4 个任务彼此独立并行执行,最后 1 个任务依赖前 4 个任务。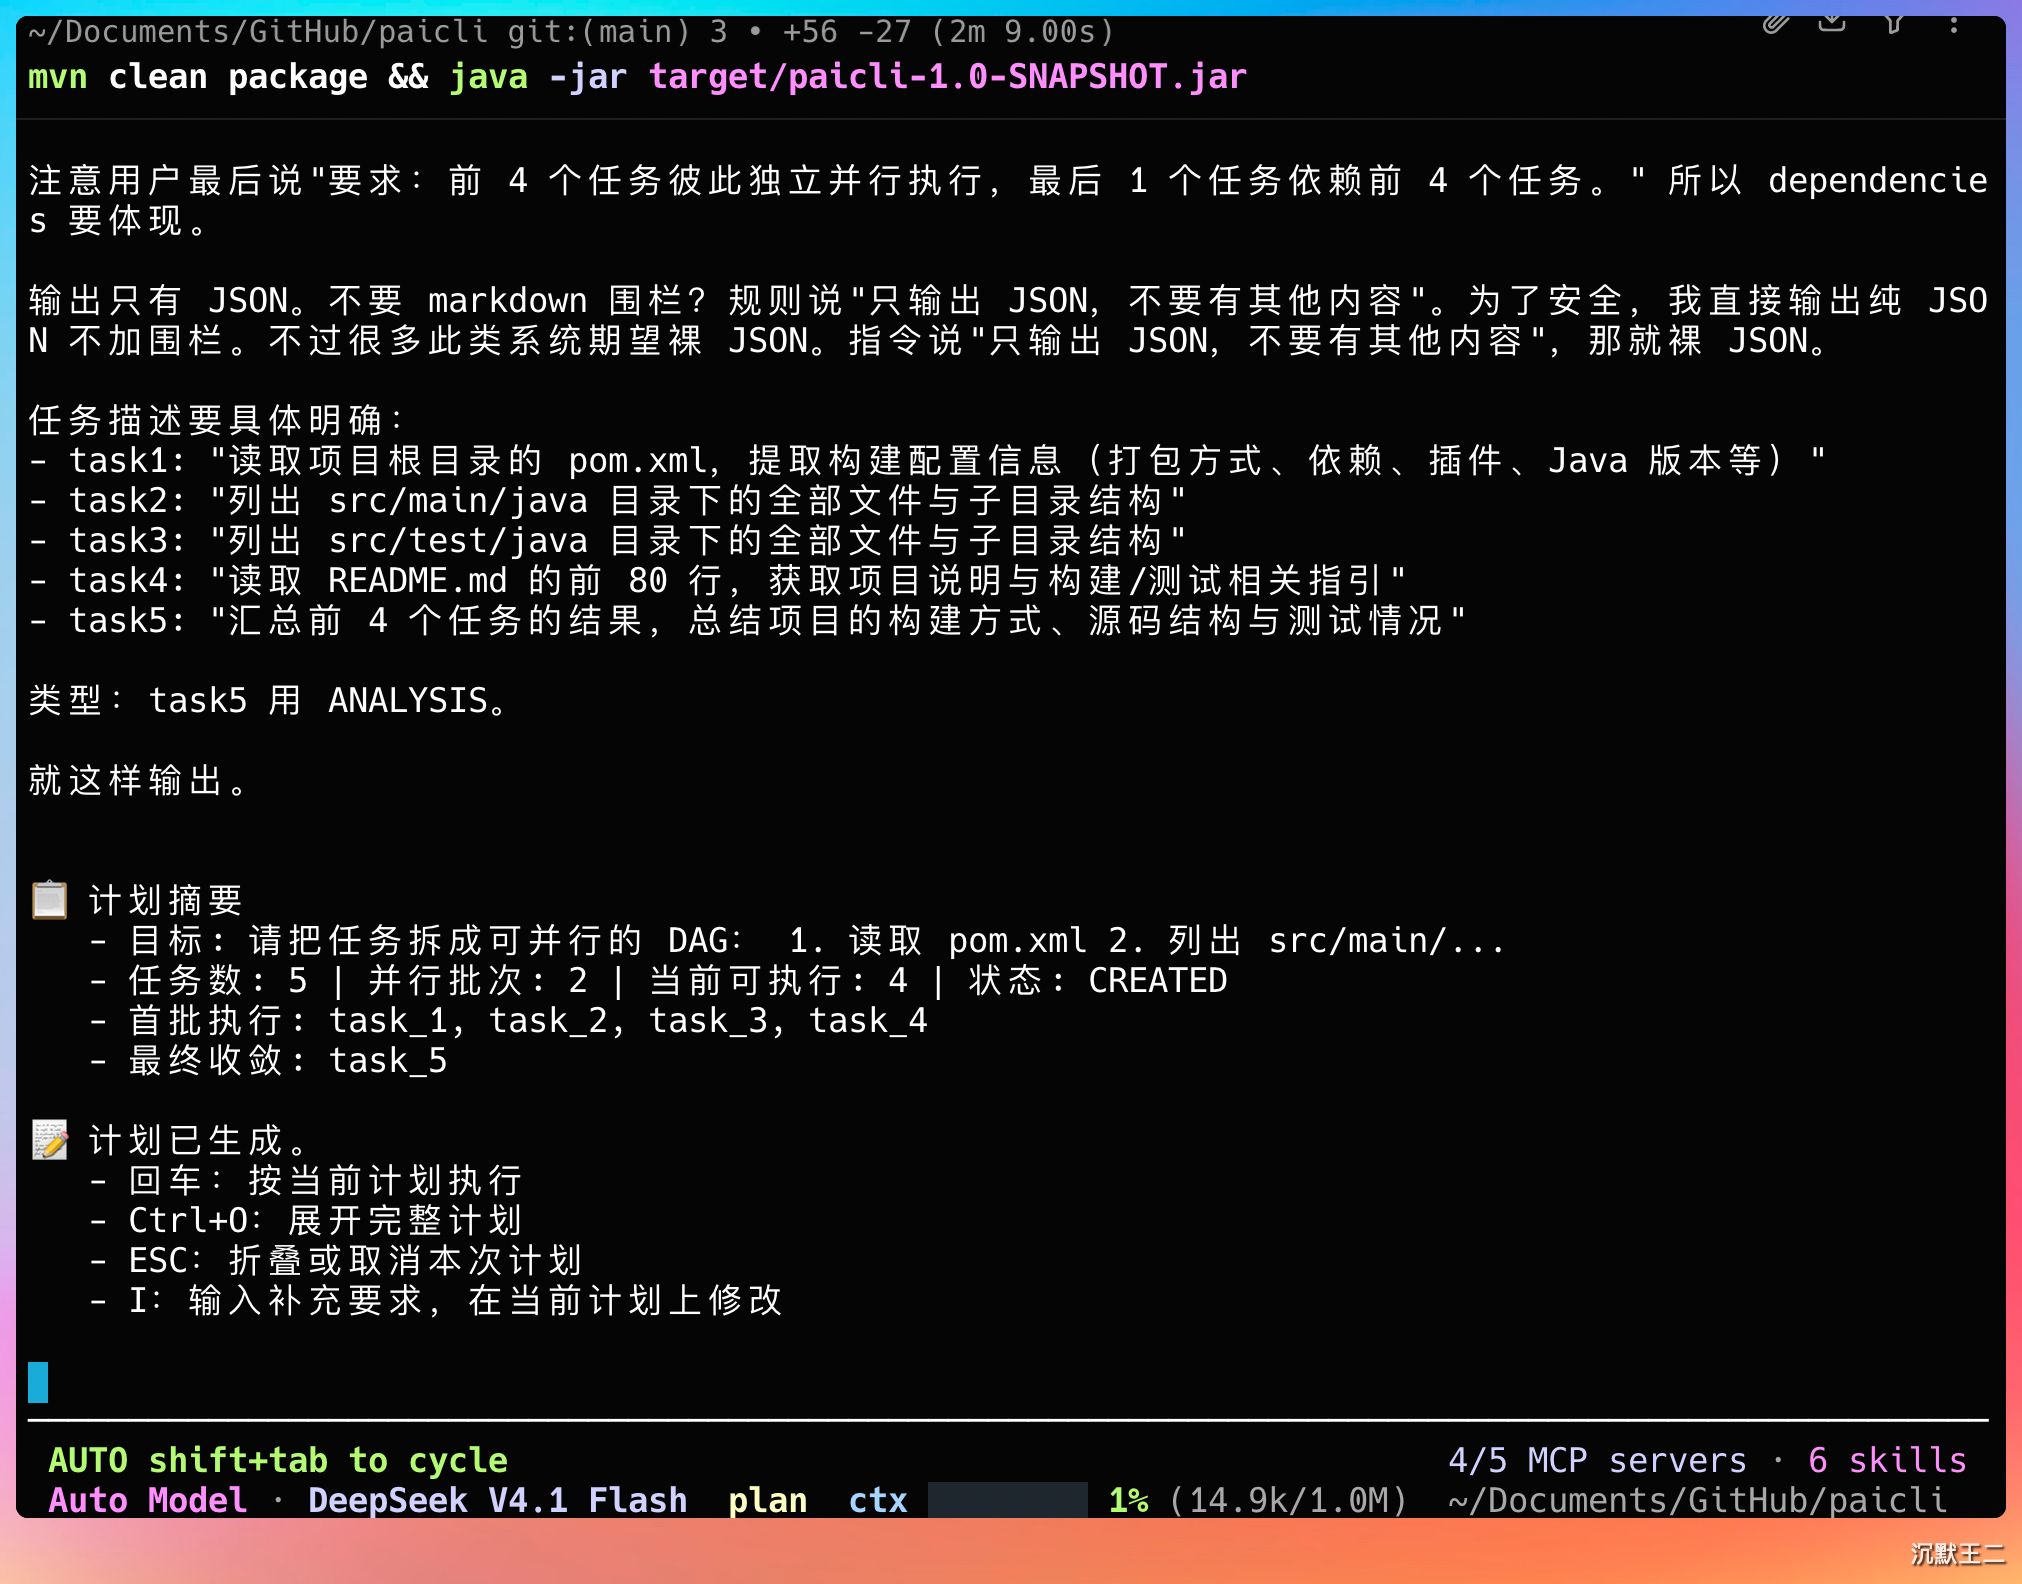
审阅时按 I,输入“汇总时用表格输出”,看模型怎么在原计划上修改。
最后按 Shift+Tab 切到 plan 模式,直接输入一条普通任务,不用再敲 /plan。
简历怎么写
PaiCLI|Java 终端 Coding Agent|核心开发 第 2 期
项目简介:在 ReAct Agent 的基础上实现 Plan-and-Execute 执行模式,由模型先生成带依赖关系的任务计划,用户审阅确认后按 DAG 分批并行执行,并支持计划修改、失败重新规划与部分结果汇总,适用于步骤多、依赖明确的本地研发任务。
技术栈:Java 17、Maven、Jackson、JLine3、ExecutorService、DAG 拓扑排序、Plan-and-Execute
核心职责:
设计 Task 和 Execution Plan 模式,用双向依赖记录上下游关系,实现五种任务状态流转;基于 DFS 后序遍历完成拓扑排序与环检测。
实现 Planner 规划器,规划请求不暴露工具,所有目标都交给 LLM 规划。
实现 DAG 调度器,每轮筛选依赖已完成的任务,用线程池最多 4 路并行;并行任务输出先写入独立缓冲区,整轮结束后按拓扑顺序输出。
设计任务间的 Context 传递机制,下游任务只接收直接依赖的完整结果,每个任务使用独立的工具策略副本,web_search 得到的可信 URL 只沿 DAG 声明的依赖向下游传递,防止跨分支的提示词注入攻击。
完成度低于 50% 时基于已完成进度重新规划且默认最多 2 次,完成度过半时跳过失败任务,下游任务继续执行;用户取消时不触发重新规划,汇总保留已完成的结果和失败、跳过原因。
集成 JLine3 实现计划审阅交互,支持回车执行、Ctrl+O 展开任务图、ESC 取消和补充要求后在原计划基础上修改,并接入 Shift+Tab 会话模式,plan 模式下普通输入自动走计划执行。